DeepSeek vs. Qwen vs. Kimi in der Aktienanalyse
DeepSeek, Qwen, Kimi, GLM und MiniMax lasen dasselbe Datenblatt zu 11 Aktien. Wie sich Einschätzung, Überzeugung und Widerspruch unterschieden – mit Methode.
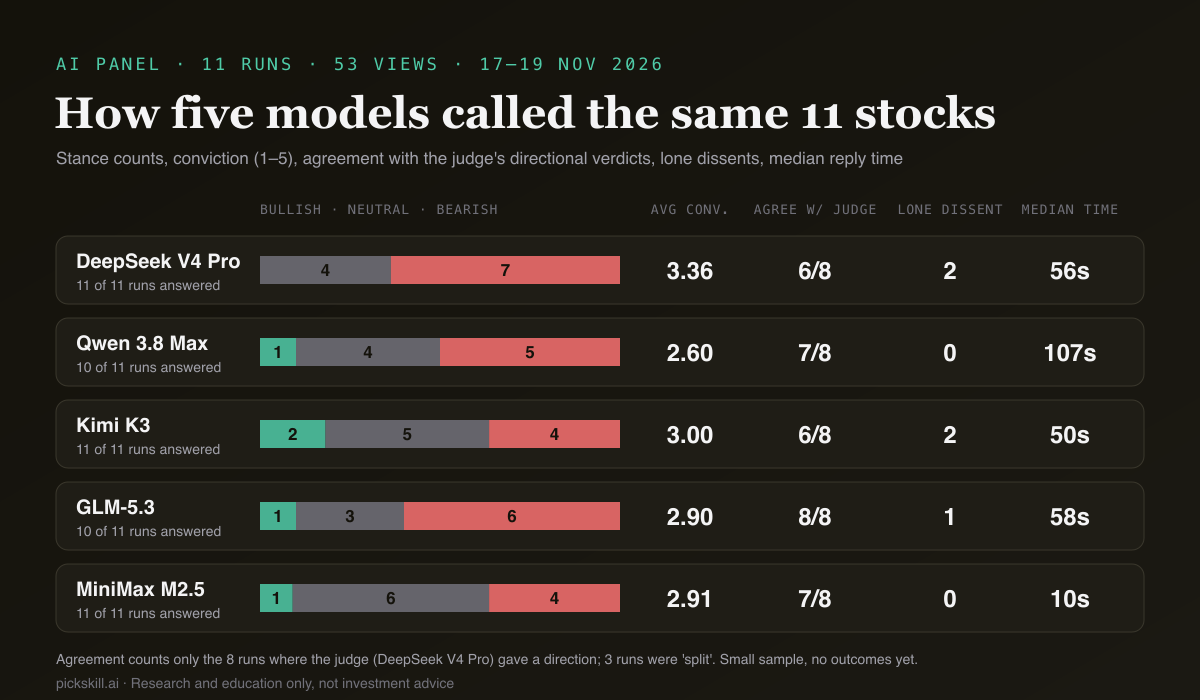
In unseren Daten gibt es noch kein „bestes“ KI-Modell für die Aktienanalyse, aber klare Unterschiede im Verhalten: Mit demselben Datenblatt war DeepSeek V4 Pro am entschiedensten, Qwen 3.8 Max am vorsichtigsten und Kimi K3 am häufigsten bereit, aus der Reihe zu tanzen. Ein Vergleich DeepSeek vs. Qwen vs. Kimi ist ein Test, wie jedes große Sprachmodell (LLM) identische Marktdaten in eine Einschätzung, einen Überzeugungswert und einen Plan übersetzt. Über 11 Läufe des PickSkill KI-Panel mit Daten vom 17.–19. Nov. 2026 lag DeepSeek im Schnitt bei einer Überzeugung von 3,36 von 5 und gab nie eine bullishe Einschätzung ab; Qwen kam im Schnitt auf 2,60 und ging nie über 3.
Das ist ein Verhaltensvergleich, keine Rangliste der Trefferquote. Die Läufe sind erst wenige Tage alt, es gibt also noch keine Ergebnisse zum Auswerten, und 11 Läufe (53 Modell-Einschätzungen) sind eine kleine Stichprobe. Zeigen können die Daten, wie sich die Modelle unterscheiden, wenn sonst nichts anders ist.
Key takeaways
- Gleicher Input, unterschiedliches Temperament. Alle fünf Modelle lasen pro Lauf ein Datenblatt. DeepSeek V4 Pro war in 7 von 11 Läufen bearish und in keinem bullish; MiniMax M2.5 blieb in 6 von 11 neutral.
- Die Spanne der Überzeugung ist schmal, aber real. DeepSeek vergab in 5 von 11 Einschätzungen eine 4; Qwen jedes Mal eine 2 oder 3. Niemand nutzte 1 oder 5.
- Kimi K3 widerspricht am häufigsten. Es war zweimal der einzige Ausreißer und als einziges Modell bullish für 600674.SS. Auch DeepSeek stand zweimal allein gegen den Rest.
- Zuverlässigkeit und Tempo unterscheiden sich. Qwen fiel in einem Lauf aus (es lief in das 170-Sekunden-Limit) und hatte mit 107 s die langsamste Median-Antwortzeit; MiniMax antwortete im Median in 10 s.
- Dieselbe Aktie zweimal, unterschiedliche Urteile. NVDA lief zweimal mit identischen Daten; drei der vier Modelle, die beide Male antworteten, änderten ihre Einschätzung.
- Keine Rangliste der Trefferquote. n = 11 Läufe, noch keine Ergebnisse. Lesen Sie das als „wie sich jedes Modell verhält“, nicht als „welches Modell recht hat“.
Was genau haben wir verglichen?
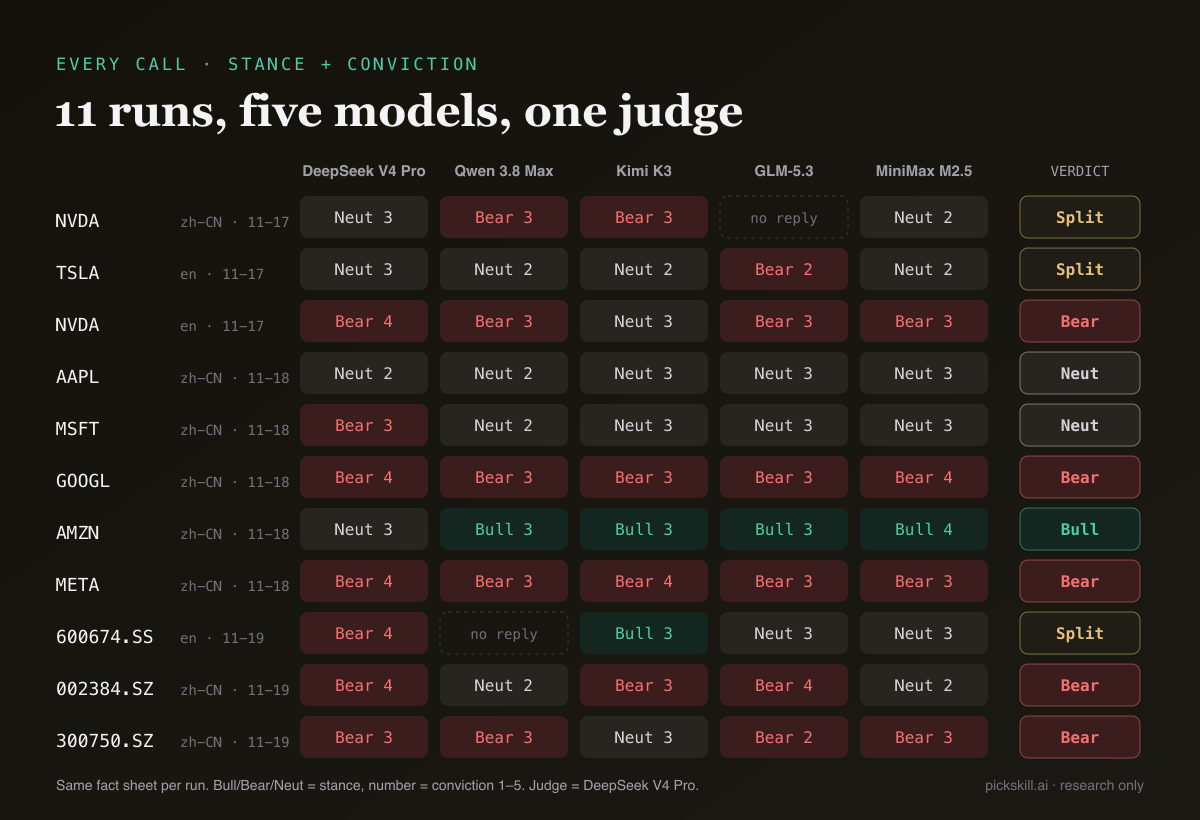
Wir haben fünf LLMs verglichen, die im KI-Panel von PickSkill sitzen: DeepSeek V4 Pro, Qwen 3.8 Max, Kimi K3, GLM-5.3 und MiniMax M2.5. In jedem Lauf erhält jedes Modell dasselbe JSON-Datenblatt zu einer Aktie: jüngste Kursentwicklung, acht technische Signale (MACD, gleitende Durchschnitte, RSI, KDJ, Bollinger-Bänder, ADX, Volumen, Geldfluss) jeweils mit 5-Tage-Verlauf, Bewertungskennzahlen und die letzten Quartalszahlen. Jedes Modell liefert eine Einschätzung (bullish, bearish oder neutral), eine Überzeugung von 1 bis 5, einen Zeithorizont, Gründe, Risiken und eine Long-only-Strategie. DeepSeek V4 Pro fungiert anschließend als Richter: Es liest alle Einschätzungen und schreibt ein Urteil (bullish, bearish, neutral oder gespalten). Unsere Stichprobe umfasst jeden gespeicherten Lauf vom 17.–19. Nov. 2026: NVDA zweimal, TSLA, AAPL, MSFT, GOOGL, AMZN, META und drei chinesische A-Aktien (600674.SS, 002384.SZ, 300750.SZ). Das ergibt 55 mögliche Einschätzungen; 53 kamen an.
Warum sind identische Inputs für einen fairen Vergleich so wichtig?
Nur mit identischen Inputs lässt sich ein Unterschied im Output dem Modell selbst zuschreiben. Fragen Sie DeepSeek, Qwen und Kimi in ihren eigenen Chat-Apps nach einer Aktie, sucht womöglich jedes Modell anders im Web, sieht Kurse von verschiedenen Tagen, bekommt andere System-Prompts und liest andere Nachrichten. Ein Widerspruch sagt dann wenig aus: Es könnten die Daten sein, nicht das Urteilsvermögen. Im Panel erhält jedes Modell eines Laufs dasselbe Datenblatt, dieselben Anweisungen („nur die bereitgestellten Fakten verwenden, nie Zahlen erfinden“) und dasselbe Ausgabeschema, und alle fünf werden im selben Moment parallel aufgerufen. Was danach variiert – Einschätzung, Überzeugung oder gewählte Kursmarken – kommt vom Modell. Der Test ist fair, aber eng gefasst: Er prüft das Schlussfolgern über strukturierte Daten, nicht das Lesen von Nachrichten oder Bewertungsarbeit.
Wie unterschieden sich DeepSeek, Qwen und Kimi?
DeepSeek V4 Pro war am entschiedensten und am pessimistischsten, Qwen 3.8 Max am zurückhaltendsten und Kimi K3 am unabhängigsten. DeepSeek stufte keine einzige Aktie bullish ein; seine 11 Einschätzungen teilten sich in 7 bearish und 4 neutral, bei einer durchschnittlichen Überzeugung von 3,36, dem höchsten Wert der fünf. Qwen vergab viermal eine 2 und sechsmal eine 3, nie mehr, und hatte damit den niedrigsten Schnitt (2,60). Kimi hatte die meisten bullishen Einschätzungen (2), lag in 9 von 11 Fällen bei Überzeugung 3 und war zweimal der einzige Abweichler: neutral beim englischsprachigen NVDA-Lauf und bei 300750.SZ, während die anderen vier bearish waren.
| Modell | Einschätzungen | Bullish / Neutral / Bearish | Ø Überzeugung | Einig mit Richter* | Einziger Abweichler | Median-Antwortzeit |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 11 / 11 | 0 / 4 / 7 | 3,36 | 6 / 8 | 2 | 56 s |
| Qwen 3.8 Max | 10 / 11 | 1 / 4 / 5 | 2,60 | 7 / 8 | 0 | 107 s |
| Kimi K3 | 11 / 11 | 2 / 5 / 4 | 3,00 | 6 / 8 | 2 | 50 s |
| GLM-5.3 | 10 / 11 | 1 / 3 / 6 | 2,90 | 8 / 8 | 1 | 58 s |
| MiniMax M2.5 | 11 / 11 | 1 / 6 / 4 | 2,91 | 7 / 8 | 0 | 10 s |
*Gezählt nur in den 8 Läufen, in denen der Richter eine Richtung vorgab; 3 Läufe waren „gespalten“. Daten: PickSkill-KI-Panel-Läufe mit Daten vom 17.–19. Nov. 2026.
Zwei Muster fallen auf. Erstens tendierte das Panel insgesamt bearish (26 bearishe, 22 neutrale, 5 bullishe Einschätzungen), was vor allem die Inputs widerspiegelt: Viele dieser Aktien fielen, NVDA etwa verlor in fünf Tagen 7,95 % auf 155,46 (Schlusskurs 17. Nov.). Zweitens sagte das Feld Zeithorizont nichts aus: Alle 53 Einschätzungen wählten „Wochen“, weil der Prompt nach einem Ausblick auf ein bis vier Wochen fragt. Einen ausführlichen Durchgang durch einen Lauf finden Sie in fünf KI-Modelle analysieren NVDA.
Welches Modell widersprach den anderen am häufigsten?
Kimi K3 und DeepSeek V4 Pro scherten je zweimal aus einem sonst einstimmigen Panel aus, GLM-5.3 einmal, Qwen 3.8 Max und MiniMax M2.5 nie. Als „einzigen Widerspruch“ zählen wir nur, wenn alle anderen Modelle eines Laufs dieselbe Einschätzung teilen und dieses Modell eine andere vertritt. DeepSeeks zwei Widersprüche gingen in entgegengesetzte Richtungen: bearish bei MSFT, als die anderen vier neutral waren, und neutral bei AMZN, als die anderen vier bullish waren. GLMs einziger Widerspruch war bearish bei TSLA gegen vier neutrale Einschätzungen. Am stärksten gespalten war der Lauf zu 600674.SS (Sichuan Chuantou Energy): Kimi bullish, DeepSeek bearish, GLM und MiniMax neutral, und der Richter urteilte „gespalten“. Nur 3 von 11 Läufen waren einstimmig: AAPL (alle neutral), GOOGL und META (alle bearish).
Ein Widerspruch ist kein Fehler; oft benennt er ein Risiko, das die Mehrheit übersehen hat. Kimis neutrale NVDA-Einschätzung etwa stützte sich auf überverkaufte Werte (RSI nahe 22), während die anderen den Abwärtstrend und den Geldfluss stärker gewichteten.
Ist der Richter zugunsten von DeepSeek voreingenommen?
Das ist möglich, und Sie sollten es beim Lesen der Spalte „Einig mit Richter“ im Hinterkopf behalten. Der Richter ist DeepSeek V4 Pro, also dasselbe Modell wie einer der Panelisten. Forschung zu LLM-as-a-Judge-Aufbauten hat einen „Self-Enhancement“-Bias dokumentiert, bei dem ein Modell Antworten bevorzugt, die seinen eigenen ähneln (Zheng et al., 2023). In unseren 11 Läufen ist der Effekt nicht sichtbar: DeepSeeks eigene Einschätzung stimmte nur 6 von 8 Mal mit dem Urteil überein, gemeinsam die niedrigste Quote, während GLM-5.3 auf 8 von 8 kam. Bei MSFT folgte der Richter den vier neutralen Einschätzungen statt DeepSeeks bearisher, bei AMZN den vier bullishen statt DeepSeeks neutraler. Der Richter sieht zudem die Stimmauszählung, sodass „Übereinstimmung mit dem Richter“ teilweise Übereinstimmung mit der Mehrheit misst.
Gibt dasselbe Modell zweimal dieselbe Antwort?
Nicht verlässlich. NVDA lief zweimal mit demselben Datenblatt (Schlusskurs 17. Nov., 155,46), einmal mit Ausgabe auf Chinesisch und einmal auf Englisch. Von den vier Modellen, die beide Male antworteten, änderten drei ihre Einschätzung: DeepSeek von neutral (3) zu bearish (4), Kimi von bearish (3) zu neutral (3) und MiniMax von neutral (2) zu bearish (3). Nur Qwen blieb beide Male bei bearish mit Überzeugung 3. Das Urteil des Richters wechselte von „gespalten“ zu „bearish“. Ob die Ausgabesprache oder schlicht der Zufall beim Sampling den Wechsel auslöste, können wir nicht sagen – bei nur einem Paar ist beides möglich. So oder so: Eine Antwort eines Modells ist eine Stichprobe, keine Messung.
Wie können Sie KI-Modelle für die Aktienanalyse selbst vergleichen?
Sie können diesen Vergleich mit beliebigen Modell-Outputs nachbauen, solange die Inputs identisch waren. So sind wir vorgegangen:
- Input fixieren. Geben Sie jedem Modell dieselben datierten Daten (ein Datenblatt pro Aktie), dieselben Anweisungen und dasselbe Ausgabeschema.
- Strukturierte Outputs sammeln. Verlangen Sie Einschätzung, Überzeugung von 1–5 und Zeithorizont als Felder, damit Sie zählen können, statt Fließtext zu interpretieren.
- Ausfälle protokollieren. Halten Sie fest, welches Modell nicht antwortete und warum (hier: ein Timeout, eine fehlende Antwort). Fehlende Daten sind auch ein Verhalten.
- Zählen, nicht benoten. Erfassen Sie pro Modell Einschätzungen, durchschnittliche Überzeugung, Übereinstimmung mit dem Endurteil und Einzel-Widersprüche.
- Vor einem Ranking die Ergebnisse abwarten. Für die Trefferquote braucht es Kurse nach Ablauf des Horizonts, idealerweise über viele Läufe und Marktphasen.
Der Kern unseres Skripts, angewendet auf die exportierten Läufe:
for run in runs:
    views, verdict = run["result"]["views"], run["result"]["summary"]["verdict"]
    for m in MODELS:
        if m not in views:
            missing[m].append(run["ticker"]); continue
        v = views[m]
        stance[m][v["stance"]] += 1; conviction[m].append(v["conviction"])
        if verdict != "split":
            judged[m] += 1; agree[m] += v["stance"] == verdict
        others = {views[o]["stance"] for o in views if o != m}
        if len(views) >= 3 and len(others) == 1 and v["stance"] not in others:
            lone[m] += 1
Welches KI-Modell ist also das beste für die Aktienanalyse?
Nach 11 Läufen lautet die ehrliche Antwort: Es hängt davon ab, was Sie vom Modell erwarten, und die Trefferquote ist noch unbekannt. Wer eine entschiedene Einschätzung mit klaren Marken will, bekam sie am deutlichsten von DeepSeek V4 Pro. Wer eine vorsichtige Zweitmeinung sucht: Qwen 3.8 Max ging selten über Überzeugung 3, war aber am langsamsten und lief einmal in ein Timeout. Kimi K3 stellt einen Konsens am ehesten infrage. GLM-5.3 lag am nächsten am Endurteil, und MiniMax M2.5 war mit Abstand am schnellsten. Die Streuung zwischen ihnen ist das eigentlich nützliche Signal – deshalb zeigt das PickSkill KI-Panel alle fünf Einschätzungen nebeneinander, samt Übereinstimmungen und Widersprüchen laut Richter. Wie sich das in einen breiteren Workflow einfügt, zeigt unser Leitfaden KI für die Aktienrecherche 2026.
Wir wiederholen den Vergleich, sobald genug Läufe ihren Horizont überschritten haben, um sie an den Kursen zu messen. Nur zu Recherche- und Bildungszwecken, keine Anlageberatung.
FAQ
Ist DeepSeek besser als Qwen für die Aktienanalyse? In unseren 11 Läufen mit Daten vom 17.–19. Nov. 2026 war DeepSeek V4 Pro entschiedener (durchschnittliche Überzeugung 3,36 gegenüber 2,60) und pessimistischer als Qwen 3.8 Max, doch es gibt noch keine Ergebnisse, um die Treffsicherheit zu beurteilen. „Besser“ hängt davon ab, ob Sie eine klare oder eine vorsichtige Einschätzung wollen – und von Trefferdaten, deren Erhebung Wochen dauert.
Welches LLM analysiert Aktien am besten? Auf Basis unserer Daten hat sich noch kein LLM als verlässlich bestes erwiesen. Bei identischen Inputs unterschieden sich die fünf getesteten Modelle vor allem in Überzeugung, Häufigkeit des Widerspruchs, Zuverlässigkeit und Tempo. Mehrere Modelle auf demselben Datenblatt zu vergleichen und auf ihre Übereinstimmungen zu achten, ist aussagekräftiger, als einer einzelnen Antwort zu vertrauen.
Warum gibt dasselbe KI-Modell zur selben Aktie unterschiedliche Antworten? Sprachmodelle erzeugen ihre Ausgabe per Sampling, daher kann derselbe Input in einem anderen Lauf zu einer anderen Einschätzung führen. In unseren Daten wurde NVDA zweimal mit identischen Zahlen analysiert, und drei von vier Modellen änderten ihre Einschätzung. Betrachten Sie jede einzelne KI-Antwort als eine Stichprobe und suchen Sie nach Übereinstimmung über Modelle oder Läufe hinweg.
Wie bestimmt das PickSkill KI-Panel das Endurteil? DeepSeek V4 Pro übernimmt die Rolle des Richters. Es liest die Einschätzungen aller fünf Analysten und die nach Überzeugung gewichtete Abstimmung und schreibt dann ein Urteil (bullish, bearish, neutral oder gespalten), die wichtigsten Übereinstimmungen und Widersprüche, eine Long-only-Strategie und worauf als Nächstes zu achten ist. Kostenlose Konten erhalten einen KI-Panel-Lauf pro Monat; eine Aktie, die am selben Tag schon jemand analysiert hat, lädt kostenlos.
Kann ich die vollständigen Analysen hinter diesen Statistiken sehen? Ja. Der NVDA-Lauf ist in unserem Beitrag über fünf KI-Modelle, die NVDA analysieren, ausführlich beschrieben. Nach der Anmeldung können Sie das Panel auf der KI-Panel-Seite auch selbst für US-, Hongkong-, chinesische A-, japanische und koreanische Aktien starten und die Gründe, Risiken und Kursmarken jedes Modells einsehen.