DeepSeek vs Qwen vs Kimi pour l'analyse boursière
DeepSeek, Qwen, Kimi, GLM et MiniMax ont lu la même fiche sur 11 actions. Comment leurs avis, leur conviction et leurs désaccords diffèrent, méthode incluse.
Nos données ne désignent pas encore de « meilleur » modèle d'IA pour l'analyse boursière, mais elles montrent des comportements nettement différents : face à la même fiche de données, DeepSeek V4 Pro a été le plus tranché, Qwen 3.8 Max le plus prudent et Kimi K3 le plus enclin à se démarquer du groupe. Comparer DeepSeek, Qwen et Kimi, c'est tester la façon dont chaque grand modèle de langage (LLM) transforme des données de marché identiques en avis, en niveau de conviction et en plan. Sur 11 analyses du Panel IA de PickSkill portant sur des données du 17 au 19 nov. 2026, DeepSeek a affiché une conviction moyenne de 3,36 sur 5 sans jamais émettre d'avis haussier ; Qwen a affiché 2,60 en moyenne sans jamais dépasser 3.
Il s'agit d'une comparaison de comportements, pas d'un classement de précision. Les analyses ne datent que de quelques jours : aucun résultat n'est encore mesurable, et 11 analyses (53 avis de modèles) forment un petit échantillon. Ce que les données peuvent montrer, c'est en quoi les modèles diffèrent quand rien d'autre ne change.
Key takeaways
- Même entrée, tempéraments différents. Les cinq modèles lisent une seule fiche par analyse. DeepSeek V4 Pro a été baissier sur 7 des 11 analyses et jamais haussier ; MiniMax M2.5 est resté neutre sur 6 des 11.
- L'écart de conviction est étroit mais réel. DeepSeek a donné une conviction de 4 dans 5 avis sur 11 ; Qwen a donné 2 ou 3 à chaque fois. Personne n'a utilisé 1 ni 5.
- Kimi K3 est le contradicteur le plus fréquent. Il a été deux fois le seul à diverger et le seul modèle haussier sur 600674.SS. DeepSeek s'est lui aussi retrouvé seul contre tous à deux reprises.
- Fiabilité et rapidité varient. Qwen a manqué une analyse (il a atteint la limite de 170 secondes) et affiche le temps de réponse médian le plus lent, 107 s ; MiniMax a répondu en 10 s en médiane.
- La même action, deux fois, deux verdicts. NVDA a été analysée deux fois sur des données identiques ; trois des quatre modèles ayant répondu les deux fois ont changé d'avis.
- Pas un classement de précision. n = 11 analyses, aucun résultat pour l'instant. À lire comme « comment chaque modèle se comporte », pas « quel modèle a raison ».
Qu'avons-nous comparé exactement ?
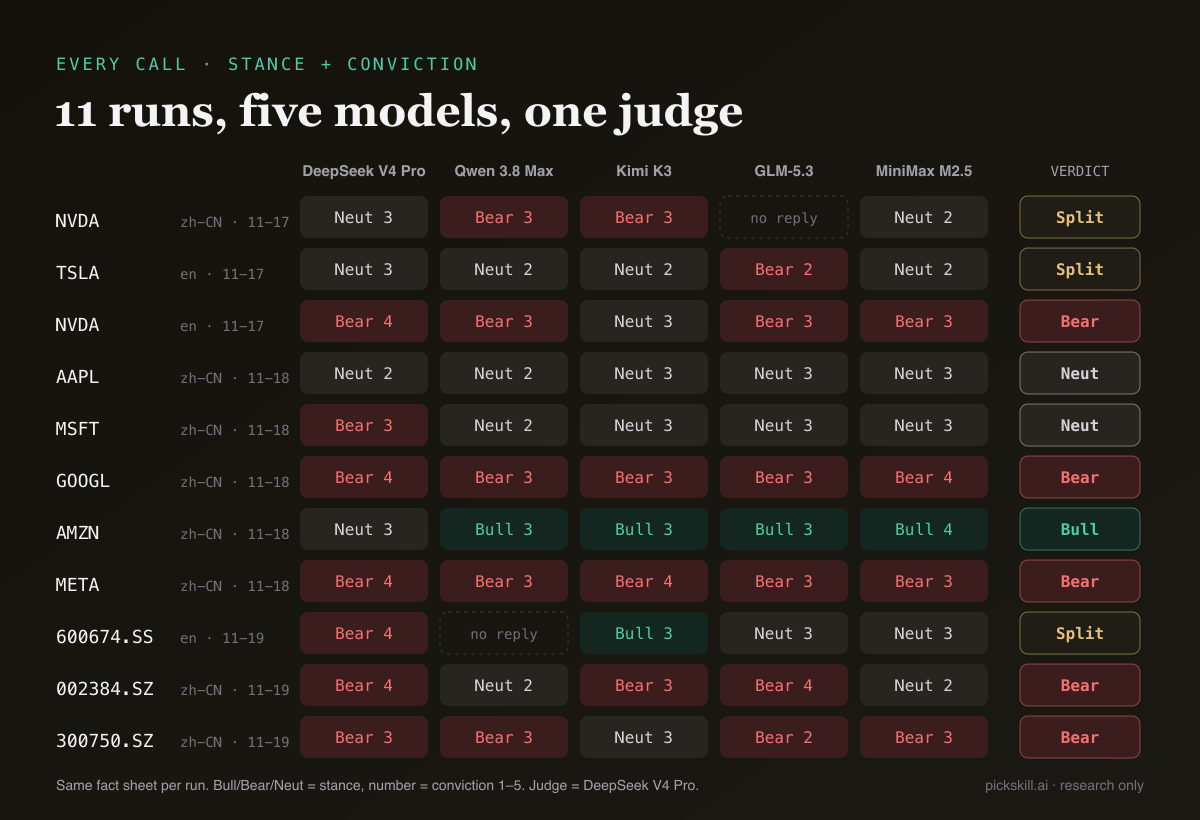
Nous avons comparé les cinq LLM qui siègent au Panel IA de PickSkill : DeepSeek V4 Pro, Qwen 3.8 Max, Kimi K3, GLM-5.3 et MiniMax M2.5. À chaque analyse, chaque modèle reçoit la même fiche JSON sur une action : évolution récente du cours, huit signaux techniques (MACD, moyennes mobiles, RSI, KDJ, bandes de Bollinger, ADX, volume, flux de capitaux) chacun avec son historique sur 5 jours, ratios de valorisation et derniers résultats trimestriels. Chaque modèle renvoie un avis (haussier, baissier ou neutre), une conviction de 1 à 5, un horizon, des arguments, des risques et une stratégie long-only (sans vente à découvert). DeepSeek V4 Pro joue ensuite le rôle de juge : il lit tous les avis et rend un verdict (haussier, baissier, neutre ou partagé). Notre échantillon couvre toutes les analyses enregistrées du 17 au 19 nov. 2026 : NVDA deux fois, TSLA, AAPL, MSFT, GOOGL, AMZN, META et trois actions A chinoises (600674.SS, 002384.SZ, 300750.SZ). Soit 55 avis possibles ; 53 ont été rendus.
Pourquoi des entrées identiques sont-elles indispensables à une comparaison équitable ?
Seules des entrées identiques permettent d'attribuer une différence de résultat au modèle lui-même. Si vous interrogez DeepSeek, Qwen et Kimi sur une action dans leurs propres applications de chat, chacun peut chercher différemment sur le web, voir des cours de jours différents, recevoir d'autres instructions système et lire d'autres actualités. Un désaccord n'apprend alors pas grand-chose : il peut venir des données, pas du raisonnement. Dans le panel, chaque modèle d'une analyse reçoit la même fiche, les mêmes consignes (« utiliser uniquement les faits fournis, ne jamais inventer de chiffres ») et le même format de sortie, et les cinq sont appelés en parallèle au même instant. Tout ce qui varie ensuite — avis, conviction ou niveaux de prix retenus — vient du modèle. Le test est équitable mais ciblé : il mesure le raisonnement sur des données structurées, pas la lecture de l'actualité ni le travail de valorisation.
En quoi DeepSeek, Qwen et Kimi se sont-ils distingués ?
DeepSeek V4 Pro a été le plus tranché et le plus baissier, Qwen 3.8 Max le plus mesuré et Kimi K3 le plus indépendant. DeepSeek n'a jamais jugé une action haussière ; ses 11 avis se répartissent en 7 baissiers et 4 neutres, avec une conviction moyenne de 3,36, la plus élevée des cinq. Qwen a donné une conviction de 2 dans quatre avis et de 3 dans six, jamais plus, soit la moyenne la plus basse (2,60). Kimi compte le plus d'avis haussiers (2), s'est situé à 3 de conviction dans 9 avis sur 11 et a été deux fois le seul dissident : neutre sur l'analyse NVDA en anglais et sur 300750.SZ, quand les quatre autres étaient baissiers.
| Modèle | Avis | Haussier / Neutre / Baissier | Conviction moy. | D'accord avec le juge* | Seul dissident | Réponse médiane |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 11 / 11 | 0 / 4 / 7 | 3,36 | 6 / 8 | 2 | 56 s |
| Qwen 3.8 Max | 10 / 11 | 1 / 4 / 5 | 2,60 | 7 / 8 | 0 | 107 s |
| Kimi K3 | 11 / 11 | 2 / 5 / 4 | 3,00 | 6 / 8 | 2 | 50 s |
| GLM-5.3 | 10 / 11 | 1 / 3 / 6 | 2,90 | 8 / 8 | 1 | 58 s |
| MiniMax M2.5 | 11 / 11 | 1 / 6 / 4 | 2,91 | 7 / 8 | 0 | 10 s |
*Compté uniquement sur les 8 analyses où le juge a tranché dans un sens ; 3 analyses étaient « partagées ». Données : analyses du Panel IA PickSkill sur des données du 17 au 19 nov. 2026.
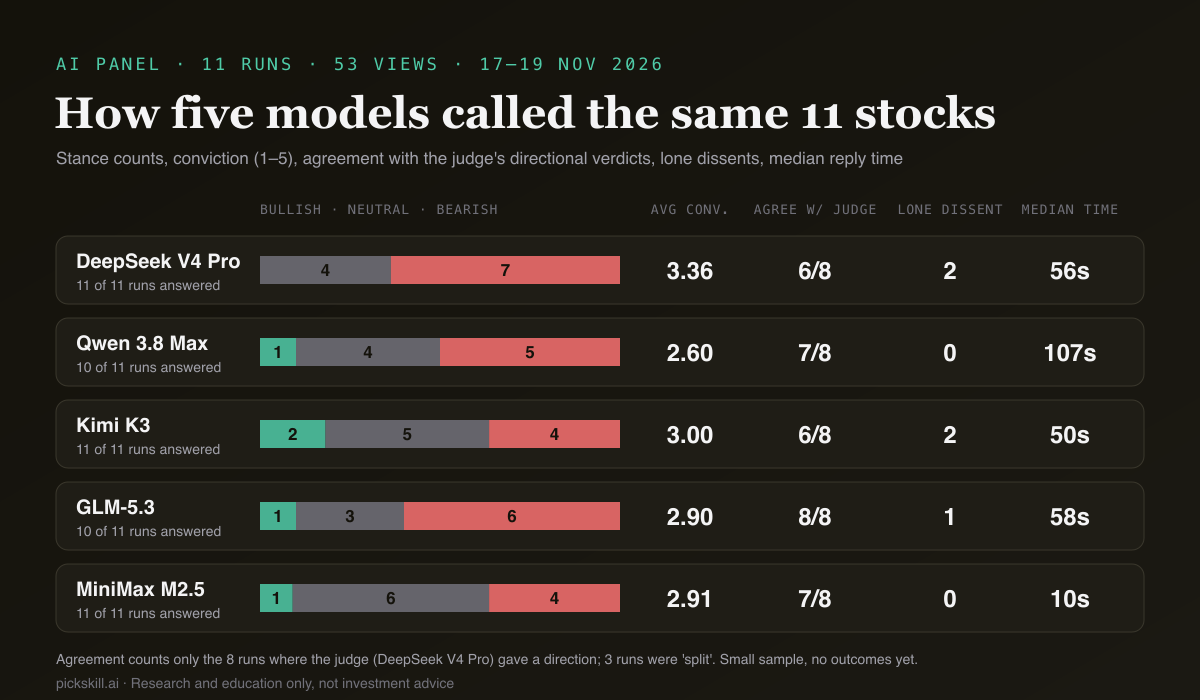
Deux tendances ressortent. D'abord, le panel penchait globalement à la baisse (26 avis baissiers, 22 neutres, 5 haussiers), ce qui reflète surtout les données d'entrée : beaucoup de ces actions reculaient, NVDA ayant perdu 7,95 % en cinq jours à 155,46 à la clôture du 17 nov. Ensuite, le champ horizon n'a rien révélé : les 53 avis ont choisi « semaines », car la consigne demande une vue à une à quatre semaines. Pour le détail complet d'une analyse, voir cinq modèles d'IA analysent NVDA.
Quel modèle s'est le plus souvent opposé aux autres ?
Kimi K3 et DeepSeek V4 Pro se sont chacun écartés deux fois d'un panel par ailleurs unanime, GLM-5.3 une fois, Qwen 3.8 Max et MiniMax M2.5 jamais. Nous ne comptons une « dissidence isolée » que lorsque tous les autres modèles de l'analyse partagent le même avis et que ce modèle en défend un autre. Les deux dissidences de DeepSeek allaient en sens opposés : baissier sur MSFT quand les quatre autres étaient neutres, et neutre sur AMZN quand les quatre autres étaient haussiers. L'unique dissidence de GLM était baissière sur TSLA face à quatre avis neutres. L'analyse la plus divisée portait sur 600674.SS (Sichuan Chuantou Energy) : Kimi haussier, DeepSeek baissier, GLM et MiniMax neutres, et un verdict « partagé ». Seules 3 analyses sur 11 ont été unanimes : AAPL (tous neutres), GOOGL et META (tous baissiers).
Une dissidence n'est pas une erreur ; elle signale souvent un risque que la majorité a négligé. L'avis neutre de Kimi sur NVDA, par exemple, s'appuyait sur des niveaux de survente (RSI proche de 22), quand les autres pesaient davantage la tendance baissière et les flux de capitaux.
Le juge favorise-t-il DeepSeek ?
C'est possible, et il faut le garder en tête en lisant la colonne « d'accord avec le juge ». Le juge est DeepSeek V4 Pro, le même modèle que l'un des panélistes. Les travaux sur les dispositifs « LLM-as-a-judge » ont documenté un biais d'« auto-valorisation » (self-enhancement), par lequel un modèle favorise les réponses qui ressemblent aux siennes (Zheng et al., 2023). Sur nos 11 analyses, l'effet n'est pas visible : l'avis de DeepSeek a coïncidé avec le verdict 6 fois sur 8, le taux le plus bas à égalité, quand GLM-5.3 atteint 8 sur 8. Sur MSFT, le juge s'est rangé aux quatre avis neutres plutôt qu'à l'avis baissier de DeepSeek, et sur AMZN aux quatre avis haussiers plutôt qu'à son avis neutre. Le juge voit aussi le décompte des votes : « l'accord avec le juge » mesure donc en partie l'accord avec la majorité.
Un même modèle donne-t-il deux fois la même réponse ?
Pas de façon fiable. NVDA a été analysée deux fois sur la même fiche (clôture du 17 nov., 155,46), une fois avec une sortie en chinois et une fois en anglais. Sur les quatre modèles ayant répondu les deux fois, trois ont changé d'avis : DeepSeek est passé de neutre (3) à baissier (4), Kimi de baissier (3) à neutre (3) et MiniMax de neutre (2) à baissier (3). Seul Qwen est resté baissier avec une conviction de 3 les deux fois. Le verdict du juge est passé de « partagé » à « baissier ». Impossible de dire si la langue de sortie ou le simple aléa d'échantillonnage explique ce changement : avec une seule paire, les deux sont possibles. Dans tous les cas, une réponse d'un modèle est un échantillon, pas une mesure.
Comment comparer vous-même des modèles d'IA pour l'analyse boursière ?
Vous pouvez reproduire cette comparaison avec n'importe quel ensemble de sorties de modèles, à condition que les entrées aient été identiques. Voici la méthode utilisée :
- Figer l'entrée. Donnez à chaque modèle les mêmes données datées (une fiche par action), les mêmes consignes et le même format de sortie.
- Collecter des sorties structurées. Exigez un avis, une conviction de 1 à 5 et un horizon sous forme de champs, pour pouvoir compter au lieu d'interpréter du texte.
- Consigner les échecs. Notez quel modèle n'a pas répondu et pourquoi (ici : un dépassement de délai, une réponse manquante). Une donnée manquante est aussi un comportement.
- Compter, pas noter. Recensez par modèle les avis, la conviction moyenne, l'accord avec le verdict final et les dissidences isolées.
- Attendre les résultats avant de classer. La précision exige les cours une fois l'horizon écoulé, idéalement sur de nombreuses analyses et plusieurs régimes de marché.
Le cœur de notre script, appliqué aux analyses exportées :
for run in runs:
    views, verdict = run["result"]["views"], run["result"]["summary"]["verdict"]
    for m in MODELS:
        if m not in views:
            missing[m].append(run["ticker"]); continue
        v = views[m]
        stance[m][v["stance"]] += 1; conviction[m].append(v["conviction"])
        if verdict != "split":
            judged[m] += 1; agree[m] += v["stance"] == verdict
        others = {views[o]["stance"] for o in views if o != m}
        if len(views) >= 3 and len(others) == 1 and v["stance"] not in others:
            lone[m] += 1
Alors, quel modèle d'IA est le meilleur pour l'analyse boursière ?
Sur 11 analyses, la réponse honnête est que cela dépend de ce que vous attendez du modèle, et que sa précision reste inconnue. Pour un avis tranché avec des niveaux clairs, DeepSeek V4 Pro s'est le plus engagé. Pour un second avis prudent, Qwen 3.8 Max a rarement dépassé une conviction de 3, mais il a été le plus lent et a dépassé le délai une fois. Kimi K3 est le plus susceptible de remettre en cause un consensus. GLM-5.3 a été le plus proche du verdict final, et MiniMax M2.5 de loin le plus rapide. L'écart entre eux est le signal utile, et c'est pourquoi le Panel IA de PickSkill affiche les cinq avis côte à côte, avec les points d'accord et de désaccord relevés par le juge. Pour l'intégrer à une démarche plus large, consultez notre guide l'IA pour la recherche boursière en 2026.
Nous referons cette comparaison quand suffisamment d'analyses auront dépassé leur horizon pour être confrontées aux cours. Contenu à visée de recherche et pédagogique uniquement, pas un conseil en investissement.
FAQ
DeepSeek est-il meilleur que Qwen pour l'analyse boursière ? Sur nos 11 analyses portant sur des données du 17 au 19 nov. 2026, DeepSeek V4 Pro a été plus tranché (conviction moyenne de 3,36 contre 2,60) et plus baissier que Qwen 3.8 Max, mais aucun résultat ne permet encore de dire lequel a été le plus juste. « Meilleur » dépend de ce que vous cherchez, un avis ferme ou prudent, et de données de précision qui prendront des semaines à réunir.
Quel LLM est le meilleur pour analyser des actions ? Aucun LLM ne s'est encore révélé durablement meilleur sur nos données. À entrées identiques, les cinq modèles testés différaient surtout par leur conviction, la fréquence de leurs désaccords, leur fiabilité et leur rapidité. Comparer plusieurs modèles sur la même fiche et repérer leurs points d'accord est plus instructif que de se fier à la réponse d'un seul.
Pourquoi un même modèle d'IA donne-t-il des réponses différentes sur la même action ? Les modèles de langage génèrent leur réponse par échantillonnage : une même entrée peut donc produire un avis différent d'une analyse à l'autre. Dans nos données, NVDA a été analysée deux fois sur des chiffres identiques et trois modèles sur quatre ont changé d'avis. Considérez chaque réponse d'IA comme un échantillon et cherchez la convergence entre modèles ou entre analyses.
Comment le Panel IA de PickSkill établit-il le verdict final ? DeepSeek V4 Pro fait office de juge. Il lit les avis des cinq analystes et le vote pondéré par la conviction, puis rédige un verdict (haussier, baissier, neutre ou partagé), les principaux points d'accord et de désaccord, une stratégie long-only et les éléments à surveiller. Les comptes gratuits ont droit à une analyse Panel IA par mois ; une action déjà analysée le jour même par quelqu'un s'affiche gratuitement.
Puis-je consulter les analyses complètes derrière ces statistiques ? Oui. L'analyse de NVDA est détaillée dans notre article sur cinq modèles d'IA qui analysent NVDA. Après connexion, vous pouvez aussi lancer le panel vous-même sur des actions américaines, hongkongaises, A chinoises, japonaises et coréennes depuis la page Panel IA, et consulter les arguments, risques et niveaux de prix de chaque modèle.