Kann KI Aktien auswählen? Was Tests 2026 zeigen
Was öffentliche Tests zu Aktientipps von ChatGPT, Gemini, DeepSeek & Co. ergaben, warum Antworten schwanken und wie Sie KI robuster einsetzen.
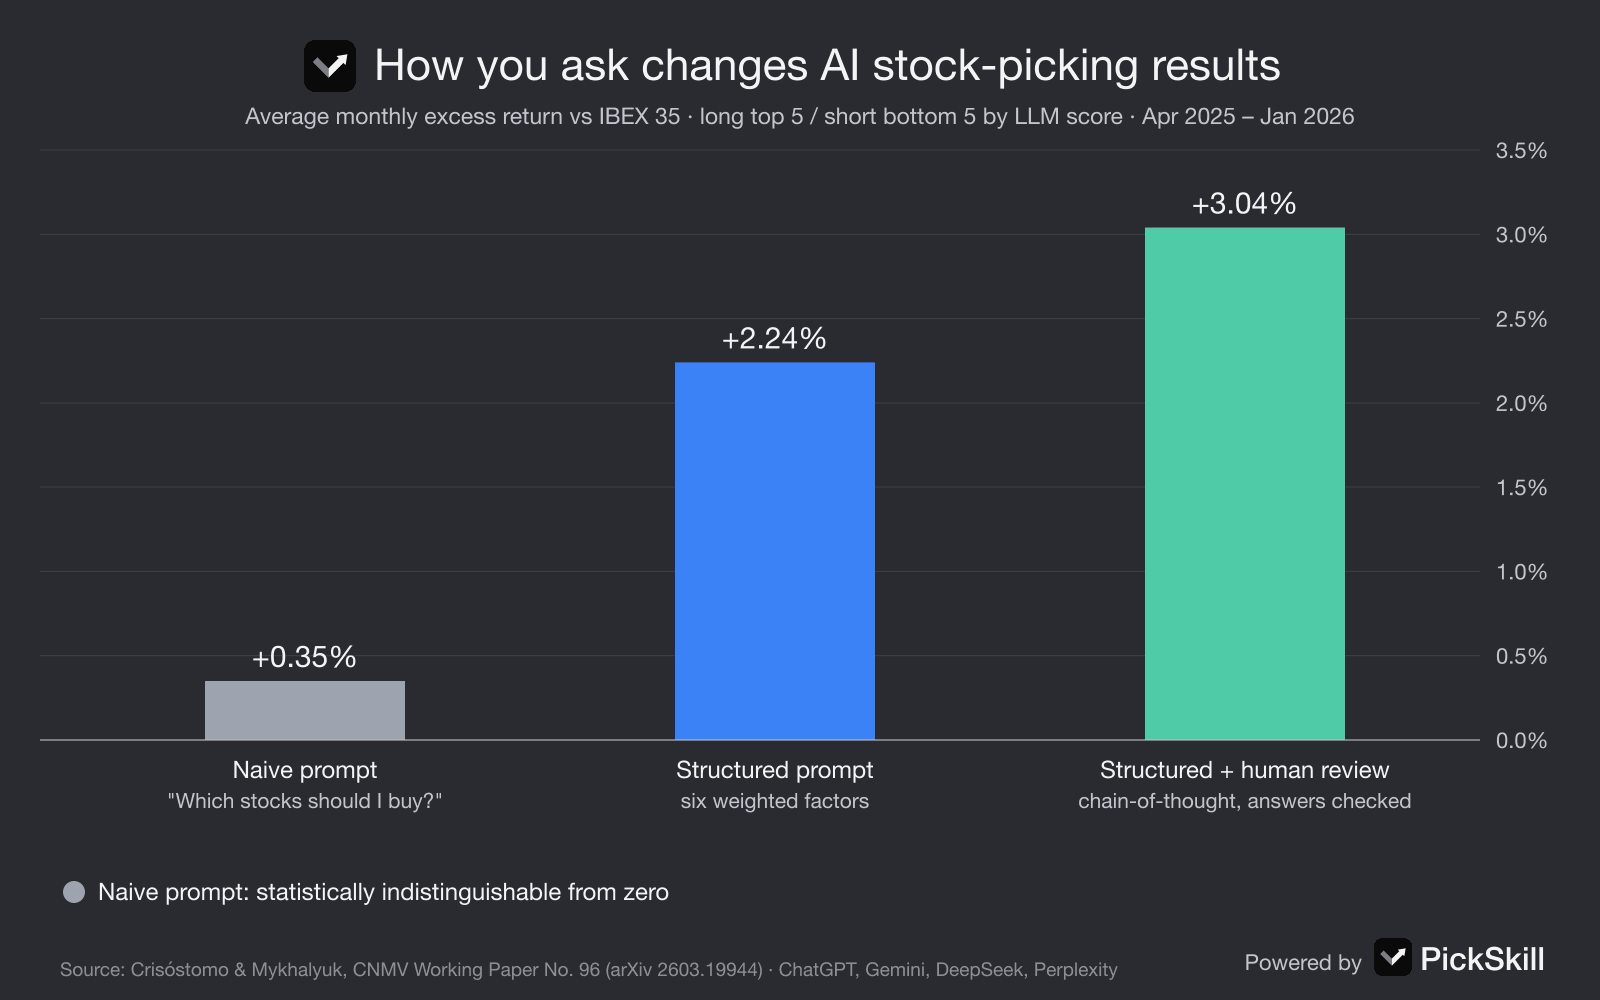
KI kann bei der Aktienanalyse helfen, aber die öffentliche Evidenz zeigt nicht, dass ein Chatbot allein zuverlässig Gewinner auswählt. KI-Aktienauswahl bedeutet, ein großes Sprachmodell (LLM) wie ChatGPT, Gemini oder DeepSeek Aktien auswählen oder ranken zu lassen, die den Markt schlagen sollen. In einem zehnmonatigen Live-Test mit IBEX-35-Aktien, veröffentlicht als CNMV Working Paper Nr. 96 (März 2026), brachten einfache Fragen wie „Welche Aktien soll ich kaufen?“ eine durchschnittliche Überrendite von 0,35 % pro Monat – laut den Autoren statistisch nicht von null zu unterscheiden.
Die Ergebnisse verbesserten sich deutlich, sobald die Prompts strukturiert waren und ein Mensch die Argumentation prüfte. Andere Tests aus 2025–2026 bestätigen das Bild: Die Ergebnisse sind gemischt, hängen stark von der Fragestellung ab, und die Antwort eines einzelnen Modells ist nicht stabil genug, um sie als Orakel zu behandeln.
Das Wichtigste in Kürze
- Die Evidenz ist gemischt. In den vier öffentlichen Experimenten unten schlugen manche KI-Portfolios ihre Benchmark, andere blieben zurück – meist über kurze Zeiträume von sechs bis zehn Monaten.
- Wie Sie fragen, zählt genauso viel wie welches Modell. In der CNMV-Studie stieg die durchschnittliche monatliche Überrendite von 0,35 % (naiver Prompt) auf 2,24 % (strukturierter Prompt) und 3,04 % (strukturiert plus menschliche Prüfung).
- Ein Modell, ein Durchlauf ist verrauscht. Die CNMV-Autoren nennen „Output-Instabilität“ (unterschiedliche Ergebnisse bei identischen Prompts) als wiederkehrenden Fehler; unser eigenes AI Panel gab NVDA mit denselben Daten im Abstand von rund 70 Minuten erst ein gespaltenes, dann ein bärisches Urteil.
- Modelle teilen blinde Flecken. Studien finden eine Neigung zu Technologie- und Large-Cap-Aktien, und eine Harvard-Studie zeigte, dass ChatGPT chinesische Aktien optimistischer sah als DeepSeek, weil negative Nachrichten fehlten.
- Nutzen Sie KI für Recherche und Zweitmeinungen, vergleichen Sie unabhängige Modelle und lesen Sie, wo sie sich widersprechen.
Kann KI wirklich Aktien auswählen, die den Markt schlagen?
Allein nicht zuverlässig – jedenfalls nach dem, was bisher veröffentlicht wurde. Der gründlichste öffentliche Test ist das CNMV Working Paper Nr. 96, „Large Language Models and Stock Investing: Is the Human Factor Required?“ von Ricardo Crisóstomo und Diana Mykhalyuk von der spanischen Wertpapieraufsicht. Von April 2025 bis Januar 2026 ließen sie ChatGPT, Gemini, DeepSeek und Perplexity am ersten Handelstag jedes Monats alle 35 IBEX-35-Werte bewerten und testeten dann ein Long-Short-Portfolio aus den fünf besten und fünf schlechtesten Werten. Naive Prompts erzielten 0,35 % Überrendite pro Monat, statistisch nicht von null zu unterscheiden. Strukturierte Prompts mit sechs gewichteten Faktoren hoben das auf 2,24 %, Chain-of-Thought-Prompts mit menschlicher Prüfung jeder Antwort auf 3,04 %. Das Fazit der Autoren: LLMs „können den Markt schlagen“, wenn sie angeleitet und überwacht werden, doch diese Outperformance ist im autonomen Einsatz „weder automatisch noch robust“.
Was haben öffentliche KI-Stockpicking-Experimente ergeben?
Vier öffentliche Tests aus 2025–2026 decken verschiedene Märkte, Modelle und Aufbauten ab, und keiner läuft lange genug, um die Frage zu entscheiden. Zusammen gelesen schwanken die Ergebnisse je nach Modell, Risikoprofil und Zeitfenster, und die besseren Ergebnisse gehen mit mehr Struktur oder menschlicher Aufsicht einher.
| Wer | Modelle | Markt und Zeitraum | Ergebnis |
|---|---|---|---|
| CNMV Working Paper Nr. 96 | ChatGPT, Gemini, DeepSeek, Perplexity | IBEX 35, Apr. 2025 – Jan. 2026, monatlich | Naive Prompts: 0,35 %/Monat Überrendite (nicht signifikant). Strukturiert: 2,24 %. Mit menschlicher Aufsicht: 3,04 %, alle vier Modelle signifikant |
| Finder AI Portfolio Showdown | ChatGPT, Gemini, Copilot, DeepSeek, Perplexity, Meta AI, Grok | Je vier Portfolios mit 10 Aktien, Jan. – Dez. 2026 (Ergebnisse bis Okt.) | Jedes aggressive Portfolio verlor Geld und lag hinter beiden Benchmarks; DeepSeeks konservatives Portfolio führte mit 15,11 % |
| Dezerv | Grok, ChatGPT, Gemini, Perplexity, Claude | Indische Aktien vs. Nifty 500 TRI, ab 4. Aug. 2025 (Zwischenstand nach sechs Monaten) | Gemini und Perplexity vorn, Grok und ChatGPT zurück, Claude etwa auf Marktniveau; der Autor hält das Ergebnis für wahrscheinlich zufallsgetrieben |
| Harvard Business School (Wang, Cao, Xiang) | ChatGPT 4.1, DeepSeek R1 | 4.978 Aktien aus Shanghai und Shenzhen, Prognosen für den 31.12.2024 | ChatGPT prognostizierte rund 12,5 % höhere Kurse als DeepSeek, mit 13 % größeren absoluten Fehlern |
Finder weist im Update vom Oktober 2026 darauf hin, dass der Test nur „einen relativ kurzen Zeitraum“ abdeckt. Der Dezerv-Beitrag nennt die Modelle „stochastische Brainstormer, keine disziplinierten Portfoliomanager“ und betont, dass Können konsistente risikoadjustierte Renditen über mehrere Marktzyklen erfordern würde. Die HBS-Studie ist ein Prognosetest und kein Portfolio, zeigt aber, wie Trainingsdaten jede Antwort in eine Richtung neigen können.
Warum ändern sich KI-Aktientipps von Durchlauf zu Durchlauf?
LLMs erzeugen Antworten per Sampling, daher kann dieselbe Frage mit anderer Gewichtung, einer anderen Aktie oder einem anderen Fazit zurückkommen. Außerdem suchen sie jedes Mal anders im Web. Die CNMV-Studie listet in ihrer Fehlertaxonomie „Such-Instabilität“ (Dutzende Quellen bei einer Anfrage, zwei bei einer vergleichbaren) und „Output-Instabilität“ (ein Score von 0,75, der sich bei einem gleichwertigen Prompt ändert), dazu veraltete Daten, erfundene Zahlen, vermischte Währungen und Rechenfehler. Der Dezerv-Autor betont ebenfalls, dass die Modelle nicht deterministisch sind und von Monat zu Monat keine Verantwortung tragen. Für Anleger ist eine Chat-Antwort damit nur eine Stichprobe aus vielen möglichen Antworten, und nichts darin verrät, welche Sie erwischt haben.
Das haben wir in unseren eigenen Daten gesehen. Das AI Panel von PickSkill lässt fünf Modelle – DeepSeek V4 Pro, Qwen 3.8 Max, Kimi K3, GLM-5.3 und MiniMax M2.5 – dasselbe Faktenblatt zu einer Aktie lesen; ein Richter-Modell fasst die Einschätzungen zusammen. Am 19. November 2026 ließen wir NVDA zweimal im Abstand von rund 70 Minuten laufen, mit denselben Daten zum Schlusskurs vom 17. November (155,46 $). Der erste Lauf wurde auf Chinesisch angefragt, der zweite auf Englisch, und im ersten Lauf kam die Einschätzung von GLM nicht zurück – ein perfekt kontrollierter Test ist das also nicht. Aufschlussreich ist das Ergebnis trotzdem:
- Lauf 1 (02:21 UTC): Qwen und Kimi bärisch, DeepSeek und MiniMax neutral. Score −0,55, Urteil gespalten. Strategie des Richters: eine kleine Probeposition in der Unterstützungszone 148,35–155,46 mit Stopp bei 148.
- Lauf 2 (03:31 UTC): GLM, Qwen, MiniMax und DeepSeek bärisch, Kimi neutral. Score −0,81, Urteil bärisch. Strategie des Richters: keine neuen Long-Positionen, bei einer Erholung Richtung 162,87 reduzieren.
- Was sich änderte: Drei der vier Modelle, die beide Male antworteten, wechselten ihre Haltung. Kimi ging von bärisch zu neutral, DeepSeek und MiniMax von neutral zu bärisch. Nur Qwen blieb dabei.
- Was blieb: Beide Läufe waren sich bei den entscheidenden Fakten einig – starker Abwärtstrend, überverkaufte Oszillatoren, Unterstützung um 148,35 – und tendierten insgesamt negativ.
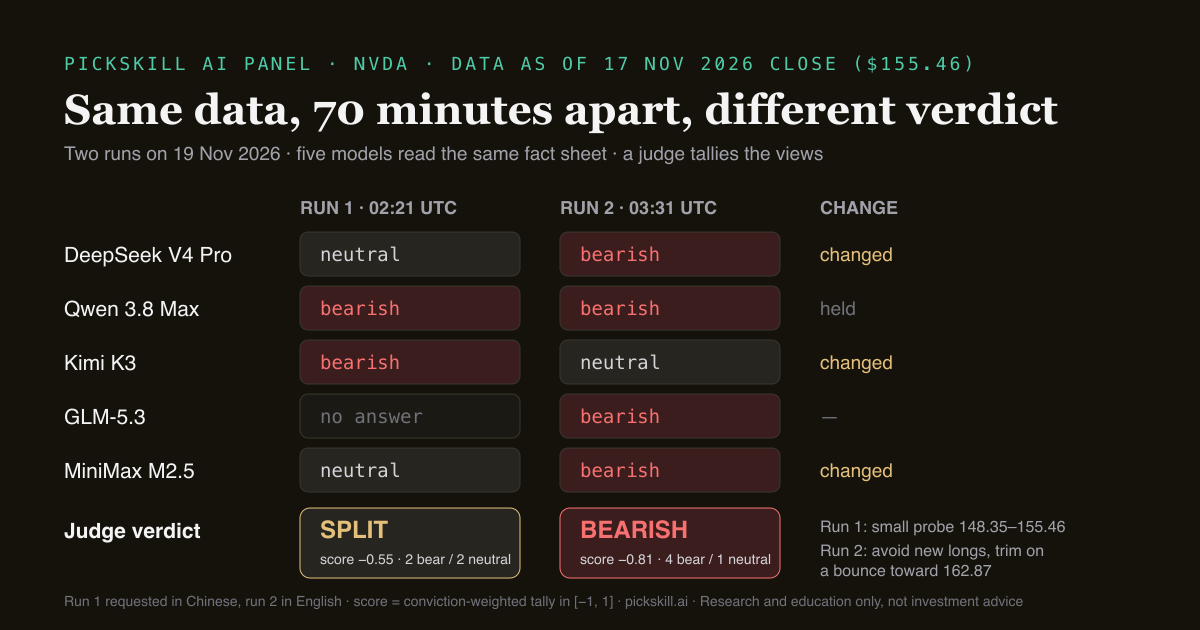
Die Richtung war stabil, Überzeugung und Handlungsempfehlung waren es nicht. Mit nur einer der beiden Antworten hätten Sie mit gleicher Zuversicht bei „auf eine Erholung setzen“ oder „meiden“ landen können.
Wählen verschiedene KI-Modelle einfach dieselben großen Aktien?
Oft ja – und das ist eher ein Risiko als eine Bestätigung. Eine Studie zu Anlage-Verzerrungen von LLMs von Hoyoung Lee und Koautoren (arXiv 2507.20957) berichtet über die meisten getesteten Modelle hinweg eine Tendenz, „Technologieaktien, Large Caps und Contrarian-Strategien zu bevorzugen“, und dass sich diese Vorlieben zu einem Bestätigungsfehler verfestigen können. Wenn mehrere Chatbots dieselbe Handvoll Mega-Caps empfehlen, wiederholen sie womöglich nur dieselben Trainingsdaten und Medienberichte, statt unabhängig zu urteilen. In der HBS-Studie verschwand ChatGPTs Optimismus gegenüber chinesischen Firmen, sobald die Forscher chinesische Nachrichtenquellen hinzufügten – die Verzerrung kam also von dem, was das Modell gelesen hatte. Auch der Dezerv-Autor warnt davor, dass viele Nutzer bei denselben KI-Tipps landen. Übereinstimmung zwischen Modellen hat nur dann Aussagekraft, wenn die Modelle unabhängig sind und mit denselben geprüften Fakten arbeiten.
Wie sollten Sie KI stattdessen für die Aktienanalyse nutzen?
Behandeln Sie KI als schnellen Research-Assistenten und Zweitmeinung, nicht als Stockpicker. Die CNMV-Ergebnisse führen zu einer einfachen Regel: Geben Sie dem Modell Struktur, geprüfte Daten und eine klare Aufgabe, und kontrollieren Sie seine Argumentation, bevor Sie handeln.
- Daten statt Gedächtnis. Lassen Sie das Modell mit einem datierten Faktenblatt arbeiten – Kursverlauf, Signale, Bewertung, letzte Quartalszahlen – statt mit dem, woran es sich erinnert. Laut CNMV-Studie verbesserten offizielle Pflichtveröffentlichungen die Prognosegenauigkeit.
- Struktur einfordern. Fragen Sie nicht „Kaufen?“, sondern nach Haltung, Zeithorizont, Gründen, Risiken und dem, was die Meinung ändern würde. Welche Inputs wohin gehören, zeigt unser Beitrag zu technischer vs. fundamentaler Analyse.
- Mehrmals und mehrere Modelle fragen. Stellen Sie dieselbe Frage mehreren unabhängigen Modellen und betrachten Sie die Streuung.
- Zuerst die Widersprüche lesen. Wo Modelle auseinanderliegen, sitzt meist die echte Unsicherheit: eine Unterstützungsmarke, ein Ergebnisrisiko, eine Bewertungsfrage.
- Selbst entscheiden, nach eigenen Risikoregeln. Kein Modell kennt Ihren Anlagehorizont, Ihre Positionsgröße oder Ihre steuerliche Situation.
PickSkill bündelt die Schritte 1, 3 und 4 auf einer Seite. Das AI Panel gibt fünf Modellen dasselbe Faktenblatt und zeigt einen nach Überzeugung gewichteten Score von −1 bis +1 sowie Haltung, Gründe und Risiken jedes Modells. Der Richter listet Übereinstimmungen und Widersprüche und gibt eines von vier Urteilen aus: bullisch, bärisch, neutral oder gespalten. In unseren 11 Panel-Läufen vom 17. bis 19. November 2026 waren sich die fünf Modelle nur bei drei Aktien einig (GOOGL und META bärisch, AAPL neutral). Für offene Fragen holt der AI-Analyst-Chat Signale und Quartalsdaten ins Gespräch. Einen breiteren Überblick gibt unser Leitfaden zu KI für Aktienanalyse 2026.
Was kann KI beim Stockpicking noch nicht?
KI kann nicht in die Zukunft sehen, nicht garantieren, dass ihre Daten aktuell sind, und nicht sagen, wie sicher sie sich sein sollte. Die öffentlichen Tests sind kurz, sechs bis zehn Monate, und betreffen bestimmte Märkte und Modellversionen, die sich alle paar Monate ändern. Die CNMV-Studie fand wiederkehrende Fehler bei Datenabruf, Interpretation von Finanzkennzahlen und Rechnen – Fehler, die gerade Anleger mit einfachen Prompts am schwersten erkennen. Unsere 11 Panel-Läufe sind viel zu wenige, um etwas über Renditen zu sagen; sie zeigen nur, wie sich die Antworten verhalten. Nutzen Sie KI, um mehr zu prüfen, nicht um das Prüfen zu überspringen. Dieser Artikel dient nur Recherche- und Bildungszwecken und ist keine Anlageberatung.
FAQ
Ist ChatGPT gut darin, Aktien auszuwählen? Die öffentliche Evidenz ist gemischt. Im CNMV Working Paper Nr. 96 lieferten einfache Gesprächs-Prompts an ChatGPT bei IBEX-35-Aktien negative Überrenditen, während strukturierte und menschlich überwachte Prompts deutlich besser abschnitten. Im Finder-Vergleich 2026 lag sein aggressives Portfolio bis Oktober 2026 bei −13,09 %. ChatGPT eignet sich eher, um Berichte zu erklären und Recherche zu strukturieren, als um allein Aktien auszuwählen.
Hat schon einmal eine KI den Aktienmarkt geschlagen? Einige KI-Portfolios haben ihre Benchmarks über kurze Zeiträume geschlagen. In der CNMV-Studie erzielten alle vier Modelle statistisch signifikante Überrenditen, allerdings nur mit strukturierten Prompts und menschlicher Prüfung jeder Antwort. Finders konservative KI-Portfolios schlugen ihre Benchmarks bis Oktober 2026 größtenteils, die aggressiven lagen alle zurück. Keiner dieser Tests ist lang genug, um dauerhaftes Können zu belegen.
Warum nennt mir die KI bei jeder Frage andere Aktien? Sprachmodelle erzeugen Antworten per Sampling und suchen bei jeder Anfrage anders im Web, sodass identische Prompts andere Aktien, Scores oder Haltungen liefern können. Die CNMV-Studie führt diese „Output-Instabilität“ als wiederkehrenden Fehler auf. Das PickSkill AI Panel änderte sein NVDA-Urteil mit denselben Daten innerhalb von rund 70 Minuten von gespalten zu bärisch.
Ist es besser, mehrere KI-Modelle statt eines zu fragen? Mehrere unabhängige Modelle, die alle dieselben geprüften Daten lesen, sind robuster als eine einzelne Antwort, weil Sie sehen, wo sie übereinstimmen und wo nicht. Übereinstimmung ist aber nur schwache Evidenz, wenn die Modelle dieselben Trainingsverzerrungen teilen, etwa eine Neigung zu großen Tech-Werten. Lesen Sie daher Widersprüche und Risiken, bevor Sie entscheiden.
Kann KI einen Finanzberater oder meine eigene Recherche ersetzen? Nein. KI kann Recherche beschleunigen, Berichte zusammenfassen und eine Zweitmeinung liefern, kennt aber Ihre Ziele, Ihren Anlagehorizont und Ihre Risikotoleranz nicht und macht Fehler bei Daten und Rechnungen. HBS-Professor Charles Wang bringt es auf den Punkt: KI-Tools „können Recherche beschleunigen, ersetzen aber nicht das menschliche Urteil“.