L'IA peut-elle choisir des actions ? Les tests 2026
Ce que montrent les tests publics de ChatGPT, Gemini, DeepSeek et autres IA en bourse, pourquoi leurs réponses varient, et comment mieux les utiliser.
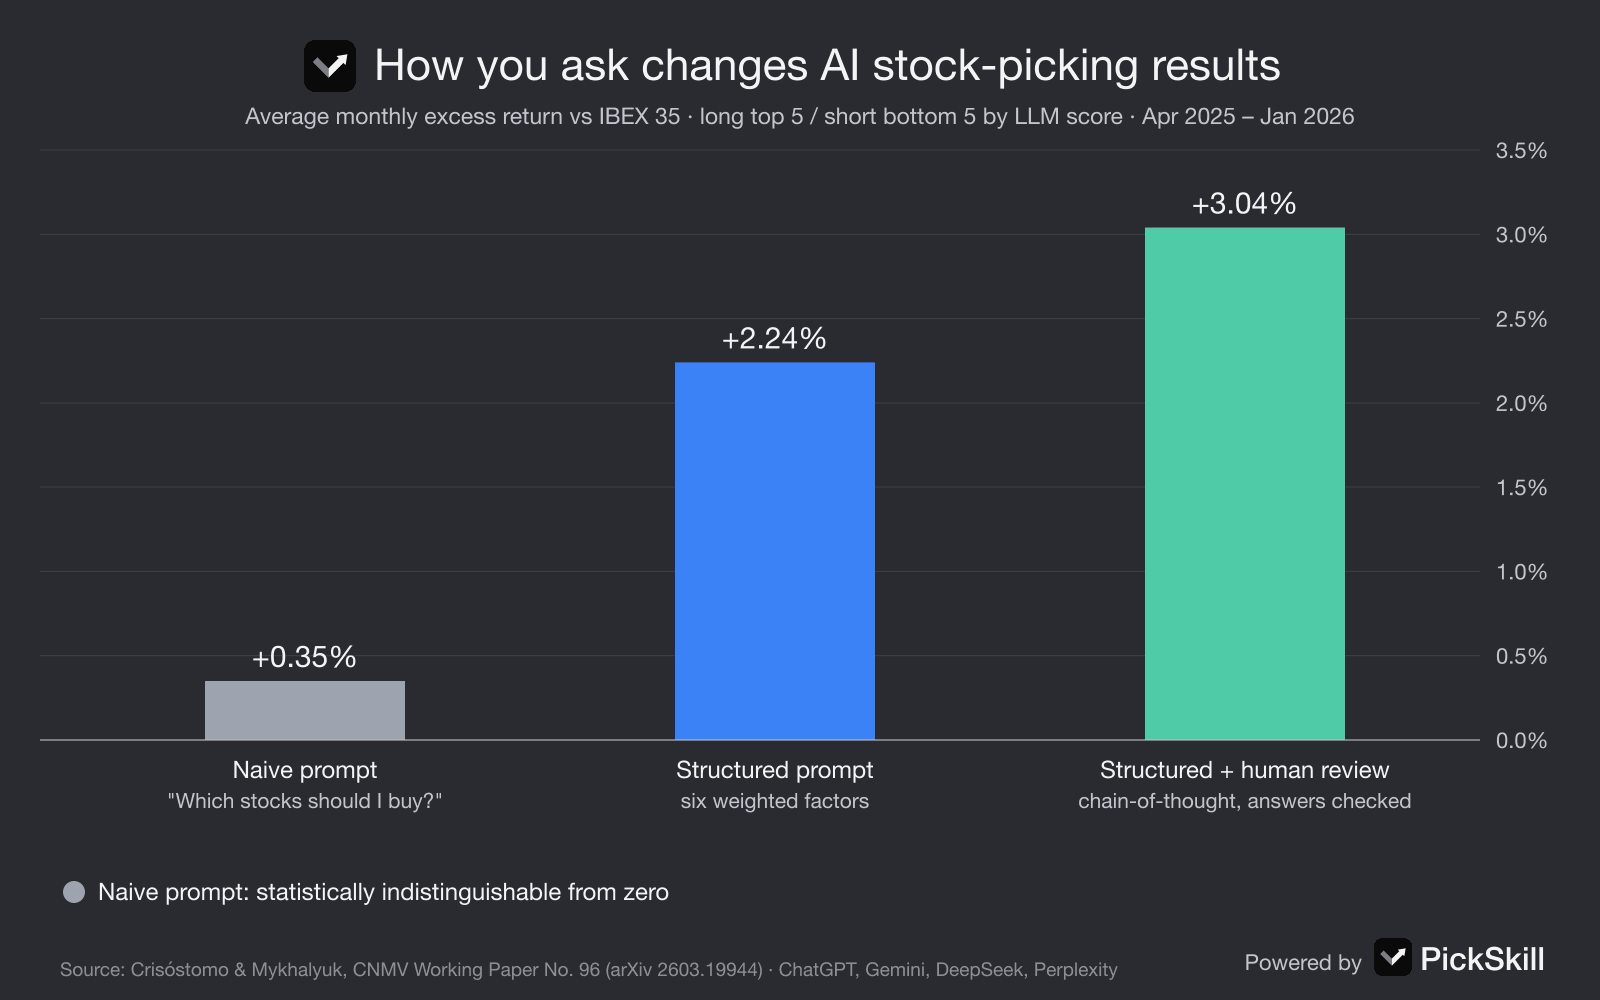
L'IA peut vous aider à analyser des actions, mais les données publiques ne montrent pas qu'un chatbot sache, seul, choisir de façon fiable les gagnantes. Choisir des actions avec l'IA, c'est demander à un grand modèle de langage (LLM) comme ChatGPT, Gemini ou DeepSeek de sélectionner ou classer les titres censés battre le marché. Dans un test en conditions réelles de dix mois sur les valeurs de l'IBEX 35, publié comme document de travail n° 96 de la CNMV (mars 2026), des questions simples du type « quelles actions acheter ? » ont produit une surperformance moyenne de 0,35 % par mois, que les auteurs jugent statistiquement indiscernable de zéro.
Les résultats se sont nettement améliorés dès que les prompts ont été structurés et qu'un humain a vérifié le raisonnement. Les autres tests de 2025–2026 vont dans le même sens : les résultats sont mitigés, dépendent fortement de la façon de poser la question, et la réponse d'un seul modèle n'est pas assez stable pour être traitée comme un oracle.
À retenir
- Les preuves sont mitigées. Dans les quatre expériences publiques ci-dessous, certains portefeuilles IA ont battu leur indice de référence et d'autres ont été distancés, souvent sur des périodes courtes de six à dix mois.
- La façon de demander compte autant que le modèle choisi. Dans l'étude de la CNMV, la surperformance mensuelle moyenne est passée de 0,35 % (prompt naïf) à 2,24 % (prompt structuré) puis 3,04 % (structuré avec relecture humaine).
- Un modèle, une réponse : beaucoup de bruit. Les auteurs de la CNMV citent « l'instabilité des résultats » (des réponses différentes pour des prompts identiques) comme un défaut récurrent ; notre propre AI Panel a donné à NVDA un verdict partagé puis baissier, sur les mêmes données, à environ 70 minutes d'intervalle.
- Les modèles partagent des angles morts. Les recherches relèvent un penchant pour la tech et les grandes capitalisations, et une étude de Harvard a montré que ChatGPT était plus optimiste que DeepSeek sur les actions chinoises faute d'actualités négatives.
- Servez-vous de l'IA pour la recherche et comme second avis, comparez des modèles indépendants et lisez leurs désaccords.
L'IA peut-elle vraiment choisir des actions qui battent le marché ?
Pas de façon fiable à elle seule, d'après ce qui a été publié jusqu'ici. Le test public le plus rigoureux est le document de travail n° 96 de la CNMV, « Large Language Models and Stock Investing: Is the Human Factor Required? », de Ricardo Crisóstomo et Diana Mykhalyuk, du régulateur boursier espagnol. D'avril 2025 à janvier 2026, ils ont demandé à ChatGPT, Gemini, DeepSeek et Perplexity, le premier jour de bourse de chaque mois, de noter les 35 valeurs de l'IBEX 35, puis ont testé un portefeuille long-short composé des cinq meilleures et des cinq moins bonnes notes. Les prompts naïfs ont dégagé 0,35 % de surperformance par mois, statistiquement indiscernable de zéro. Des prompts structurés autour de six facteurs pondérés l'ont portée à 2,24 %, et le raisonnement en chaîne (chain-of-thought) avec relecture humaine de chaque réponse à 3,04 %. Conclusion des auteurs : les LLM « peuvent battre le marché » lorsqu'ils sont guidés et supervisés, mais cette surperformance n'est « ni automatique ni robuste » en mode autonome.
Qu'ont montré les expériences publiques de sélection d'actions par l'IA ?
Quatre tests publics de 2025–2026 couvrent des marchés, des modèles et des protocoles différents, et aucun n'est assez long pour trancher. Lus ensemble, les résultats varient selon le modèle, le niveau de risque et la période, et les meilleurs s'accompagnent de plus de structure ou de supervision humaine.
| Qui | Modèles | Marché et période | Résultats |
|---|---|---|---|
| Document de travail n° 96 de la CNMV | ChatGPT, Gemini, DeepSeek, Perplexity | IBEX 35, avr. 2025 – janv. 2026, mensuel | Prompts naïfs : 0,35 %/mois (non significatif). Structurés : 2,24 %. Avec supervision humaine : 3,04 %, les quatre modèles significatifs |
| Finder AI Portfolio Showdown | ChatGPT, Gemini, Copilot, DeepSeek, Perplexity, Meta AI, Grok | Quatre portefeuilles de 10 actions par modèle, janv. – déc. 2026 (résultats à fin oct.) | Tous les portefeuilles offensifs ont perdu de l'argent et sont restés derrière les deux indices ; le portefeuille prudent de DeepSeek mène avec 15,11 % |
| Dezerv | Grok, ChatGPT, Gemini, Perplexity, Claude | Actions indiennes vs Nifty 500 TRI, depuis le 4 août 2025 (point à six mois) | Gemini et Perplexity devant, Grok et ChatGPT derrière, Claude proche du marché ; l'auteur y voit probablement du hasard |
| Harvard Business School (Wang, Cao, Xiang) | ChatGPT 4.1, DeepSeek R1 | 4 978 actions de Shanghai et Shenzhen, prévisions au 31 déc. 2024 | ChatGPT prévoyait des cours environ 12,5 % plus élevés que DeepSeek, avec des erreurs absolues 13 % plus grandes |
La mise à jour de Finder d'octobre 2026 précise que le test couvre « une période relativement courte ». L'article de Dezerv qualifie les modèles de « brainstormers stochastiques, pas de gérants de portefeuille disciplinés » et estime qu'il faudrait des rendements ajustés du risque constants sur plusieurs cycles pour prouver un savoir-faire. L'étude de HBS est un test de prévision et non un portefeuille, mais elle montre comment les données d'entraînement peuvent orienter toutes les réponses dans le même sens.
Pourquoi les recommandations de l'IA changent-elles d'une requête à l'autre ?
Les LLM génèrent leurs réponses par échantillonnage : une même question peut revenir avec un autre accent, une autre action ou une autre conclusion. Ils cherchent aussi sur le web différemment à chaque fois. La typologie d'erreurs du document de la CNMV recense « l'instabilité de recherche » (des dizaines de sources pour une requête, deux pour une requête comparable) et « l'instabilité des résultats » (une note de 0,75 qui change avec un prompt équivalent), aux côtés de données périmées, de chiffres inventés, de devises mélangées et d'erreurs de calcul. L'auteur de Dezerv fait le même constat : les modèles ne sont pas déterministes et ne rendent aucun compte d'un mois à l'autre. Pour un investisseur, une réponse de chatbot n'est qu'un échantillon parmi de nombreuses réponses possibles, et rien n'indique lequel vous avez tiré.
Nous l'avons constaté dans nos propres données. L'AI Panel de PickSkill fait lire à cinq modèles — DeepSeek V4 Pro, Qwen 3.8 Max, Kimi K3, GLM-5.3 et MiniMax M2.5 — la même fiche factuelle sur une action, puis un modèle arbitre agrège leurs avis. Le 19 novembre 2026, nous avons analysé NVDA deux fois, à environ 70 minutes d'intervalle, sur les mêmes données à la clôture du 17 novembre (155,46 $). La première analyse a été demandée en chinois et la seconde en anglais, et l'avis de GLM n'est pas revenu lors de la première : ce n'est donc pas un test parfaitement contrôlé. Le résultat reste parlant :
- Analyse 1 (02:21 UTC) : Qwen et Kimi baissiers, DeepSeek et MiniMax neutres. Score −0,55, verdict partagé. Stratégie de l'arbitre : une petite position d'essai dans la zone de support 148,35–155,46, stop à 148.
- Analyse 2 (03:31 UTC) : GLM, Qwen, MiniMax et DeepSeek baissiers, Kimi neutre. Score −0,81, verdict baissier. Stratégie de l'arbitre : éviter tout nouvel achat et alléger sur un rebond vers 162,87.
- Ce qui a changé : trois des quatre modèles ayant répondu les deux fois ont changé d'avis. Kimi est passé de baissier à neutre, DeepSeek et MiniMax de neutre à baissier. Seul Qwen a maintenu sa position.
- Ce qui est resté : les deux analyses s'accordaient sur les faits essentiels — forte tendance baissière, oscillateurs en survente, support vers 148,35 — et penchaient toutes deux du côté négatif.
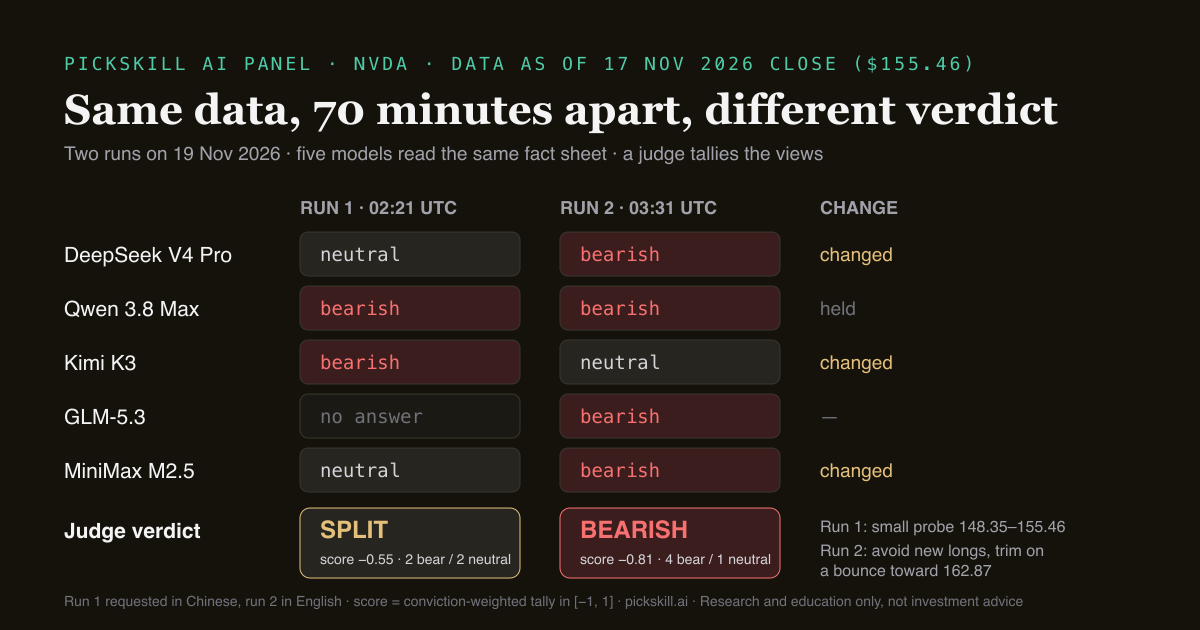
La direction était stable ; la conviction et l'action ne l'étaient pas. Avec une seule de ces réponses, vous auriez pu repartir avec « tenter le rebond » ou « s'abstenir », avec la même assurance.
Les différents modèles d'IA choisissent-ils tous les mêmes grosses valeurs ?
Souvent, oui — et c'est un risque plutôt qu'une confirmation. Une étude sur les biais d'investissement des LLM menée par Hoyoung Lee et ses coauteurs (arXiv 2507.20957) observe chez la plupart des modèles testés « une tendance à préférer les valeurs technologiques, les grandes capitalisations et les stratégies contrariennes », et note que ces préférences peuvent se figer en biais de confirmation. Quand plusieurs chatbots proposent la même poignée de méga-capitalisations, ils répètent peut-être simplement les mêmes données d'entraînement et la même couverture médiatique au lieu de conclure de façon indépendante. Dans l'étude de HBS, l'optimisme de ChatGPT envers les entreprises chinoises a disparu dès l'ajout d'actualités de sources chinoises : le biais venait de ce que le modèle avait lu. L'auteur de Dezerv met aussi en garde contre la convergence de nombreux utilisateurs vers les mêmes choix de l'IA. L'accord entre modèles n'a de valeur que s'ils sont indépendants et travaillent sur les mêmes faits vérifiés.
Comment utiliser l'IA pour analyser des actions, alors ?
Voyez l'IA comme un assistant de recherche rapide et un second avis, pas comme un sélectionneur d'actions. Les résultats de la CNMV mènent à une règle simple : donnez au modèle une structure, des données vérifiées et une tâche claire, et vérifiez son raisonnement avant d'agir.
- Ancrez-le dans les données, pas dans sa mémoire. Faites travailler le modèle sur une fiche datée — évolution du cours, signaux, valorisation, derniers résultats — plutôt que sur ce dont il se souvient. L'étude de la CNMV a montré que les publications réglementaires officielles amélioraient la précision.
- Exigez une structure. Au lieu de « j'achète ? », demandez une position, un horizon, des raisons, des risques et ce qui le ferait changer d'avis. Notre article sur l'analyse technique vs fondamentale précise quelles données relèvent de chaque approche.
- Posez la question plusieurs fois, à plusieurs modèles. Soumettez la même question à plusieurs modèles indépendants et observez la dispersion.
- Lisez d'abord les désaccords. Là où les modèles divergent se trouve souvent la vraie incertitude : un support, un risque sur les résultats, une question de valorisation.
- Décidez vous-même, selon vos propres règles de risque. Aucun modèle ne connaît votre horizon, la taille de votre position ni votre situation fiscale.
PickSkill réunit les étapes 1, 3 et 4 sur un seul écran. L'AI Panel donne la même fiche à cinq modèles et affiche un score pondéré par la conviction, de −1 à +1, avec la position, les raisons et les risques de chaque modèle. L'arbitre liste les points d'accord et de désaccord et rend l'un de quatre verdicts : haussier, baissier, neutre ou partagé. Sur nos 11 analyses du 17 au 19 novembre 2026, les cinq modèles n'ont été unanimes que sur trois actions (GOOGL et META baissiers, AAPL neutre). Pour les questions ouvertes, le chat avec l'analyste IA intègre signaux et résultats à la conversation. Notre guide de l'IA pour l'analyse d'actions en 2026 passe en revue les autres outils.
Que ne sait pas encore faire l'IA pour choisir des actions ?
L'IA ne voit pas l'avenir, ne peut pas garantir que ses données sont à jour et ne sait pas dire quel degré de confiance elle mérite. Les tests publics sont courts, de six à dix mois, et portent sur des marchés précis et des versions de modèles qui changent tous les quelques mois. Le document de la CNMV a relevé des erreurs récurrentes dans la collecte de données, l'interprétation des indicateurs financiers et les calculs — des erreurs d'autant plus difficiles à repérer pour les investisseurs qui s'en remettent à un prompt simple. Nos 11 analyses sont bien trop peu nombreuses pour dire quoi que ce soit des rendements ; elles montrent seulement comment se comportent les réponses. Servez-vous de l'IA pour vérifier davantage, pas pour vous dispenser de vérifier. Cet article est fourni à des fins de recherche et de formation uniquement et ne constitue pas un conseil en investissement.
FAQ
ChatGPT est-il bon pour choisir des actions ? Les preuves publiques sont mitigées. Dans le document de travail n° 96 de la CNMV, des prompts conversationnels simples adressés à ChatGPT ont produit une surperformance négative sur les valeurs de l'IBEX 35, alors que les prompts structurés et supervisés ont fait bien mieux. Dans le comparatif Finder 2026, son portefeuille offensif affichait −13,09 % en octobre 2026. ChatGPT est plus utile pour expliquer des rapports et structurer une analyse que pour choisir seul des actions.
Une IA a-t-elle déjà battu le marché ? Certains portefeuilles IA ont battu leur indice sur de courtes périodes. Dans l'étude de la CNMV, les quatre modèles ont obtenu une surperformance statistiquement significative, mais uniquement avec des prompts structurés et une relecture humaine de chaque réponse. Les portefeuilles IA prudents de Finder ont pour la plupart battu leurs indices jusqu'en octobre 2026, tandis que tous les offensifs sont restés derrière. Aucun de ces tests n'est assez long pour prouver un talent durable.
Pourquoi l'IA me propose-t-elle des actions différentes à chaque fois ? Les modèles de langage échantillonnent leurs réponses et cherchent sur le web différemment à chaque requête : des prompts identiques peuvent donc renvoyer des actions, des notes ou des positions différentes. Le document de la CNMV classe cette « instabilité des résultats » parmi les défauts récurrents. L'AI Panel de PickSkill est passé d'un verdict partagé à un verdict baissier sur NVDA, sur les mêmes données, en environ 70 minutes.
Vaut-il mieux interroger plusieurs modèles d'IA plutôt qu'un seul ? Interroger plusieurs modèles indépendants qui lisent les mêmes données vérifiées est plus robuste que de se fier à une seule réponse, car vous voyez où ils s'accordent et où ils divergent. Mais l'accord reste une preuve faible si les modèles partagent les mêmes biais d'entraînement, comme un penchant pour les grandes valeurs tech : lisez donc les désaccords et les risques avant de décider.
L'IA peut-elle remplacer un conseiller financier ou ma propre analyse ? Non. L'IA peut accélérer la recherche, résumer des rapports et offrir un second avis, mais elle ignore vos objectifs, votre horizon et votre tolérance au risque, et elle commet des erreurs de données et de calcul. Le professeur de HBS Charles Wang le résume ainsi : les outils d'IA « peuvent accélérer la recherche, mais ne remplacent pas le jugement humain ».