DeepSeek・Qwen・Kimi 株式分析の比較
DeepSeek、Qwen、Kimi、GLM、MiniMax が同じデータで 11 銘柄を分析。強気・弱気の判断、確信度、少数意見の違いを集計方法つきで解説。
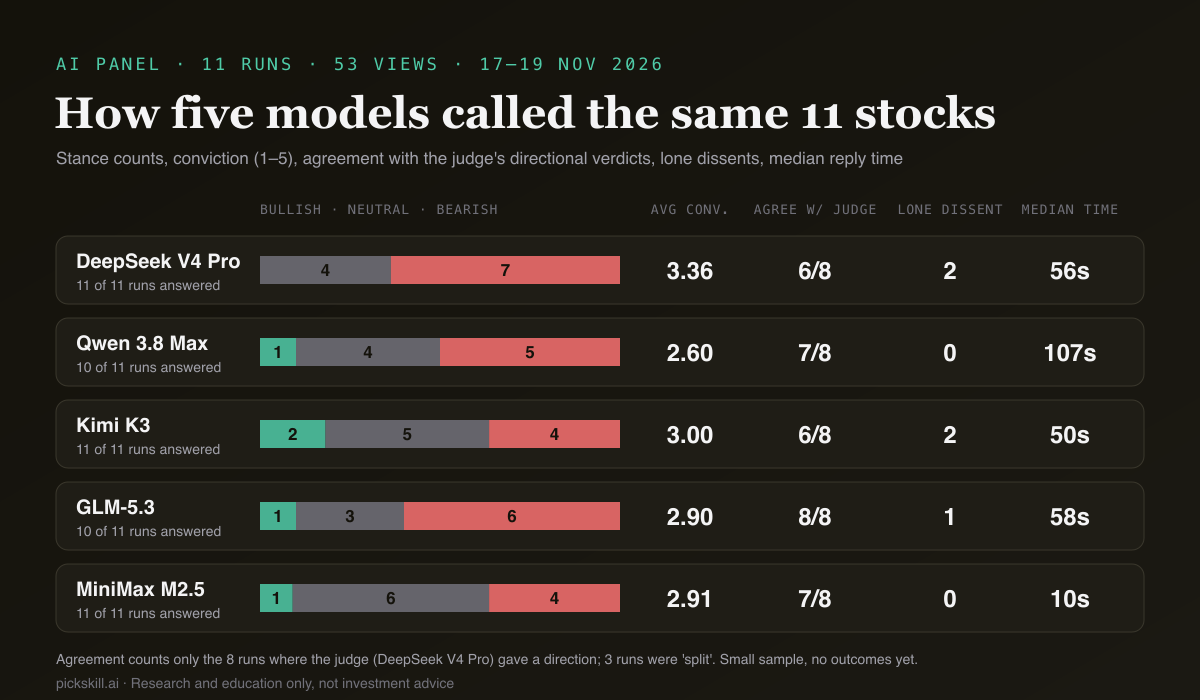
現時点のデータでは、株式分析に「最適」な AI モデルはまだ決められません。ただし振る舞いの違いははっきりしています。同じファクトシートを読ませると、DeepSeek V4 Pro は最も断定的、Qwen 3.8 Max は最も慎重、Kimi K3 は最も多数派から離れやすいモデルでした。 DeepSeek・Qwen・Kimi の比較とは、各大規模言語モデル(LLM)がまったく同じ市場データを、どのような見解・確信度・売買プランに変えるかを調べるテストです。2026 年 11 月 17〜19 日のデータに基づく PickSkill AIパネル 11 回分で、DeepSeek の平均確信度は 5 点満点中 3.36、強気判断は一度もありませんでした。Qwen の平均は 2.60 で、3 を超えたことはありません。
これは振る舞いの比較であり、精度のランキングではありません。分析から数日しか経っておらず、答え合わせできる結果はまだありません。11 回(モデルの見解 53 件)というサンプルも小さいものです。このデータでわかるのは、ほかの条件がすべて同じとき、モデル同士がどう違うかです。
要点
- 同じ入力、異なる性格。 各回で 5 モデルは同じファクトシートを読みます。DeepSeek V4 Pro は 11 回中 7 回が弱気、強気は 0 回。MiniMax M2.5 は 6 回が中立でした。
- 確信度の差は小さいが確かにある。 DeepSeek は 11 件中 5 件で確信度 4。Qwen は毎回 2 か 3 でした。1 や 5 を使ったモデルはありません。
- 少数意見が最も多いのは Kimi K3。 唯一の反対意見を 2 回出し、600674.SS で強気だったのも Kimi だけでした。DeepSeek も単独の反対意見が 2 回あります。
- 安定性と速度に差。 Qwen は 1 回回答できず(170 秒のタイムアウト)、応答時間の中央値も最も遅い 107 秒。MiniMax の中央値は 10 秒でした。
- 同じ銘柄を 2 回分析すると判断が変わる。 NVDA は同一データで 2 回実行され、両方に回答した 4 モデルのうち 3 モデルがスタンスを変えました。
- 精度ランキングではない。 n = 11 回、結果はまだ未確定。「どのモデルが正しいか」ではなく「各モデルがどう振る舞うか」として読んでください。
何を比較したのか?
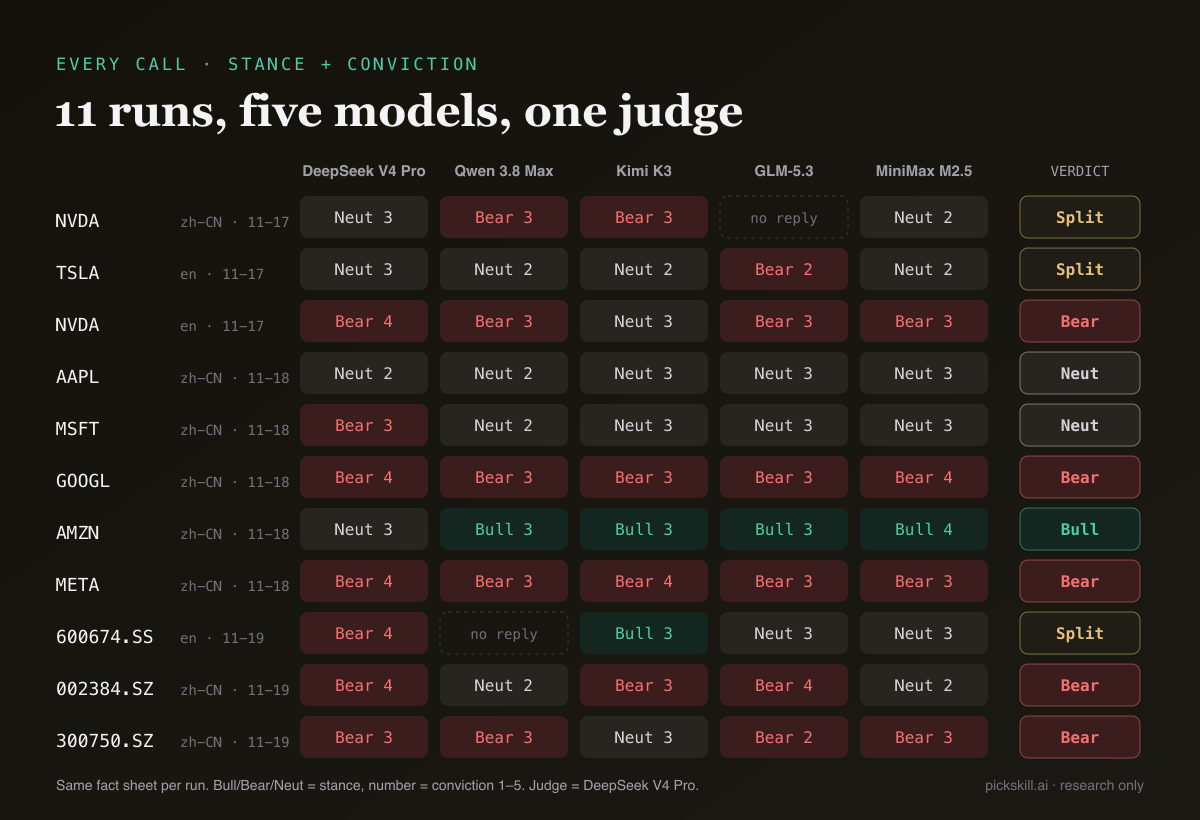
比較したのは、PickSkill の AIパネル に参加する 5 つの LLM、DeepSeek V4 Pro、Qwen 3.8 Max、Kimi K3、GLM-5.3、MiniMax M2.5 です。各回、すべてのモデルが 1 銘柄について同じ JSON ファクトシートを受け取ります。内容は直近の値動き、8 つのテクニカル指標(MACD、移動平均線、RSI、KDJ、ボリンジャーバンド、ADX、出来高、資金フロー)とそれぞれの 5 日間シグナル推移、バリュエーション指標、最新決算です。各モデルはスタンス(強気・弱気・中立)、1〜5 の確信度、時間軸、根拠、リスク、ロングオンリーの戦略を返します。その後 DeepSeek V4 Pro が審判役となり、全員の見解を読んで結論(強気・弱気・中立・見解が割れる)を出します。サンプルは 2026 年 11 月 17〜19 日に保存された全実行で、NVDA を 2 回、TSLA、AAPL、MSFT、GOOGL、AMZN、META、中国 A 株 3 銘柄(600674.SS、002384.SZ、300750.SZ)です。見解は本来 55 件のはずが、実際に届いたのは 53 件でした。
なぜ同じ入力でなければ公平な比較にならないのか?
出力の違いをモデル自体に帰属させるには、入力を完全にそろえるしかありません。DeepSeek、Qwen、Kimi にそれぞれのチャットアプリで同じ銘柄を聞くと、Web 検索の仕方も、参照する株価の日付も、システムプロンプトも、読むニュースも異なります。その状態で意見が割れても、推論の差なのかデータの差なのか判別できません。AIパネルでは、同じ回の全モデルが同じファクトシート、同じ指示(「提供されたデータだけを使い、数字を捏造しない」)、同じ出力形式を受け取り、5 モデルが同時に並列で呼び出されます。そのうえで生じるスタンス、確信度、価格水準の違いはモデル由来です。公平ではあるものの範囲は限られており、測っているのは構造化データに対する推論で、ニュース読解やバリュエーション分析ではありません。
DeepSeek、Qwen、Kimi はどう違ったのか?
DeepSeek V4 Pro は最も断定的で最も弱気寄り、Qwen 3.8 Max は最も控えめ、Kimi K3 は最も独立的でした。DeepSeek は一度も強気と判断せず、11 件の内訳は弱気 7、中立 4。平均確信度 3.36 は 5 モデル中最高です。Qwen は確信度 2 が 4 回、3 が 6 回でそれ以上はなく、平均 2.60 は最低でした。Kimi は強気判断が最多(2 回)、11 回中 9 回が確信度 3 で、唯一の反対意見を 2 回出しています。英語版 NVDA と 300750.SZ で、ほかの 4 モデルが弱気のなか Kimi だけが中立でした。
| モデル | 回答数 | 強気 / 中立 / 弱気 | 平均確信度 | 審判と一致* | 単独の反対意見 | 応答時間の中央値 |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 11 / 11 | 0 / 4 / 7 | 3.36 | 6 / 8 | 2 | 56 秒 |
| Qwen 3.8 Max | 10 / 11 | 1 / 4 / 5 | 2.60 | 7 / 8 | 0 | 107 秒 |
| Kimi K3 | 11 / 11 | 2 / 5 / 4 | 3.00 | 6 / 8 | 2 | 50 秒 |
| GLM-5.3 | 10 / 11 | 1 / 3 / 6 | 2.90 | 8 / 8 | 1 | 58 秒 |
| MiniMax M2.5 | 11 / 11 | 1 / 6 / 4 | 2.91 | 7 / 8 | 0 | 10 秒 |
*審判が方向性を示した 8 回のみで集計。残り 3 回は「見解が割れる」。データ:PickSkill AIパネル、2026 年 11 月 17〜19 日のデータに基づく実行。
目立つ点が 2 つあります。1 つ目は、パネル全体が弱気寄り(弱気 26、中立 22、強気 5)だったことです。これは主に入力を反映しています。多くの銘柄が下落中で、NVDA は 11 月 17 日終値時点で 5 日間に 7.95% 下落し 155.46 でした。2 つ目は、時間軸の項目に差が出なかったことです。プロンプトが 1〜4 週間の見通しを求めているため、53 件すべてが「数週間」を選びました。1 回分の詳しい解説は5 つの AI モデルが NVDA を分析をご覧ください。
ほかのモデルと最も意見が分かれたのはどれか?
ほかが全員一致しているなかで単独で異を唱えたのは、Kimi K3 と DeepSeek V4 Pro が各 2 回、GLM-5.3 が 1 回、Qwen 3.8 Max と MiniMax M2.5 は 0 回でした。「単独の反対意見」は、ほかのモデルのスタンスがすべて同じで、そのモデルだけが異なる場合に限って数えています。DeepSeek の 2 回は逆方向で、MSFT ではほかの 4 モデルが中立のなか弱気、AMZN ではほかの 4 モデルが強気のなか中立でした。GLM の 1 回は TSLA で、ほかの 4 モデルが中立のなか弱気です。最も意見が割れたのは 600674.SS(四川川投能源)で、Kimi が強気、DeepSeek が弱気、GLM と MiniMax が中立、審判の結論は「見解が割れる」でした。全員一致は 11 回中 3 回だけで、AAPL(全員中立)、GOOGL と META(全員弱気)です。
反対意見は誤りとは限りません。多数派が見落としたリスクを指摘していることも多いのです。たとえば Kimi の NVDA 中立判断は売られ過ぎの数値(RSI 約 22)を根拠にしており、ほかのモデルは下降トレンドと資金フローを重視していました。
審判は DeepSeek をひいきしていないか?
その可能性はあり、「審判と一致」の列を見るときは注意が必要です。審判は DeepSeek V4 Pro で、パネリストの 1 人と同じモデルです。「LLM を審判にする」研究では、モデルが自分に似た回答を好む「自己優遇(self-enhancement)バイアス」が報告されています(Zheng ほか、2023)。ただ、今回の 11 回ではその影響は見えません。DeepSeek 自身のスタンスが結論と一致したのは 8 回中 6 回で同率最下位、GLM-5.3 は 8 回中 8 回でした。MSFT では審判は DeepSeek の弱気ではなく 4 モデルの中立に、AMZN では DeepSeek の中立ではなく 4 モデルの強気に付いています。審判は投票の集計も見ているため、「審判と一致」は多数派との一致をある程度反映しています。
同じモデルに 2 回聞くと同じ答えが返るのか?
必ずしもそうではありません。NVDA は同じファクトシート(11 月 17 日終値 155.46)で 2 回実行され、1 回は中国語、1 回は英語で出力されました。両方に回答した 4 モデルのうち 3 モデルがスタンスを変えています。DeepSeek は中立(3)から弱気(4)へ、Kimi は弱気(3)から中立(3)へ、MiniMax は中立(2)から弱気(3)へ。Qwen だけが 2 回とも確信度 3 の弱気でした。審判の結論も「見解が割れる」から「弱気」に変わりました。1 組しかないため、出力言語のせいか通常のサンプリングのばらつきかは判別できません。いずれにせよ、1 つのモデルの 1 回の回答は 1 つのサンプルであって、測定値ではありません。
AI モデルの株式分析を自分で比較するには?
入力が完全に同じであれば、どのモデルの出力でもこの比較を再現できます。今回の手順は次のとおりです。
- 入力を固定する。 すべてのモデルに、日付入りの同じデータ(1 銘柄につき 1 枚のファクトシート)、同じ指示、同じ出力形式を与える。
- 構造化された出力を集める。 スタンス、1〜5 の確信度、時間軸をフィールドとして必須にし、文章を解釈せずに数えられるようにする。
- 失敗を記録する。 どのモデルが回答しなかったか、その理由を残す(今回はタイムアウト 1 回、欠落 1 回)。欠落もひとつの振る舞いです。
- 採点せず、数える。 モデルごとにスタンス、平均確信度、最終結論との一致数、単独の反対意見の回数を集計する。
- 結果が出るまでランキングしない。 精度の評価には時間軸が終わった後の株価が必要で、できれば多くの実行と異なる相場環境を含めるべきです。
エクスポートした実行データに対して動かしたスクリプトの中核部分です。
for run in runs:
    views, verdict = run["result"]["views"], run["result"]["summary"]["verdict"]
    for m in MODELS:
        if m not in views:
            missing[m].append(run["ticker"]); continue
        v = views[m]
        stance[m][v["stance"]] += 1; conviction[m].append(v["conviction"])
        if verdict != "split":
            judged[m] += 1; agree[m] += v["stance"] == verdict
        others = {views[o]["stance"] for o in views if o != m}
        if len(views) >= 3 and len(others) == 1 and v["stance"] not in others:
            lone[m] += 1
結局、株式分析に最適な AI モデルはどれか?
11 回の結果から言える正直な答えは、「モデルに何を求めるか次第で、精度はまだわからない」です。明確な価格水準を伴う断定的な見方が欲しいなら、最も強く賭けたのは DeepSeek V4 Pro です。慎重なセカンドオピニオンなら、Qwen 3.8 Max は確信度 3 を超えることがほとんどありませんが、最も遅く、1 回タイムアウトしました。コンセンサスに異を唱えやすいのは Kimi K3。最終結論に最も近かったのは GLM-5.3 で、MiniMax M2.5 は群を抜いて高速でした。モデル間のばらつきそのものが有用なシグナルであり、だからこそ PickSkill AIパネル は 5 つの見解を並べ、審判による一致点と相違点を添えて表示しています。より広いリサーチの流れの中での使い方は2026 年の AI 株式リサーチをご覧ください。
十分な数の実行が時間軸を終え、株価で採点できるようになったら、改めて比較します。本記事は調査・教育目的であり、投資助言ではありません。
FAQ
株式分析では DeepSeek と Qwen のどちらが優れていますか? 2026 年 11 月 17〜19 日のデータに基づく 11 回の実行では、DeepSeek V4 Pro は Qwen 3.8 Max より断定的(平均確信度 3.36 対 2.60)で、より弱気寄りでした。ただし、どちらが正確だったかを判断できる結果はまだありません。「優れている」かどうかは、強い見解と慎重な見解のどちらを求めるか、そして数週間かけて集まる精度データ次第です。
株の分析に最も向いている LLM はどれですか? 今回のデータでは、安定して最も優れていると示された LLM はまだありません。入力が同じ場合、5 モデルの違いは主に確信度、反対意見の頻度、安定性、速度に表れました。1 つのモデルの回答を信じるより、同じファクトシートで複数のモデルを比べ、どこで一致するかを見るほうが参考になります。
同じ AI モデルが同じ銘柄で違う答えを出すのはなぜですか? 言語モデルは出力をサンプリングで生成するため、同じ入力でも別の実行では異なるスタンスになることがあります。今回のデータでは NVDA を同一データで 2 回分析し、4 モデル中 3 モデルがスタンスを変えました。AI の回答は 1 回ごとに 1 つのサンプルと考え、複数のモデルや実行の間で一致するかを確認しましょう。
PickSkill AIパネルの最終結論はどう決まりますか? DeepSeek V4 Pro が審判を務めます。5 人のアナリストの見解と確信度で加重した投票を読み、結論(強気・弱気・中立・見解が割れる)、主な一致点と相違点、ロングオンリーの戦略、次に注目すべき点をまとめます。無料アカウントは月 1 回 AIパネルを実行でき、その日すでに誰かが分析した銘柄は無料で表示できます。
この統計の元になった分析全文は見られますか? はい。NVDA の実行は「5 つの AI モデルが NVDA を分析」の記事で詳しく紹介しています。ログインすれば、AIパネルのページから米国株、香港株、中国 A 株、日本株、韓国株を自分で分析し、各モデルの根拠、リスク、価格水準を確認できます。