DeepSeek、Qwen、Kimi 誰更會分析股票?
DeepSeek、Qwen、Kimi、GLM、MiniMax 讀同一份資料分析 11 檔股票:看多看空、信心分數、唱反調次數有何不同,附統計方法。
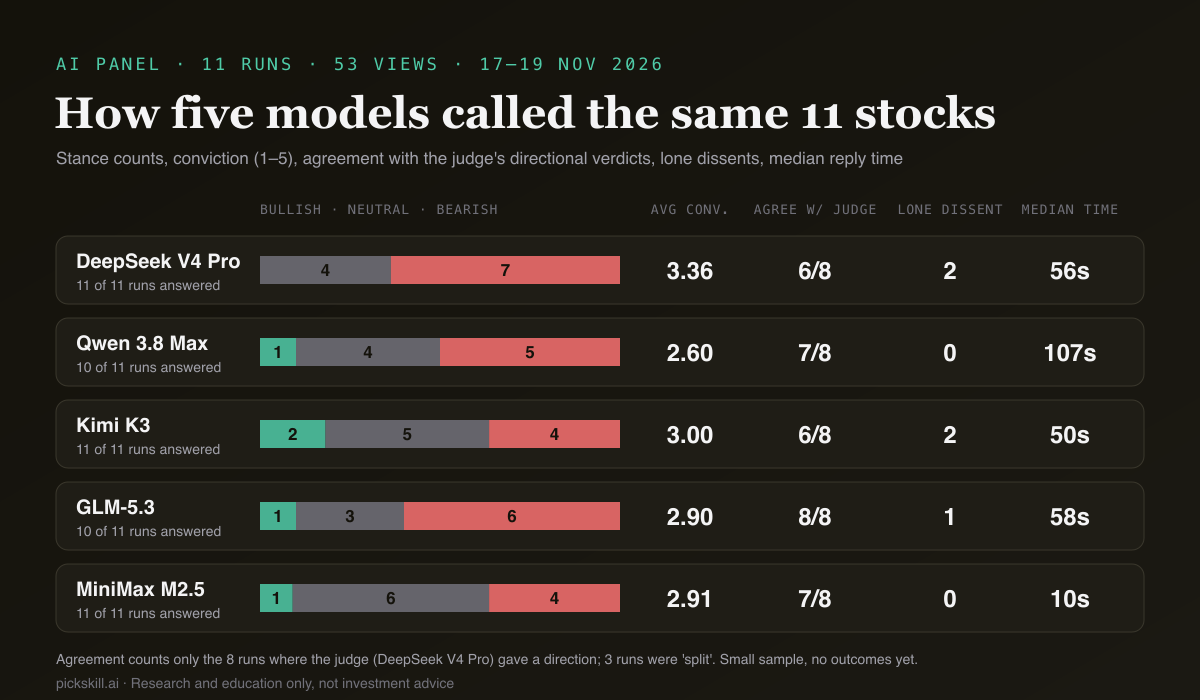
以目前的資料來看,還談不上哪個 AI 模型分析股票「最好」,但它們的行為差異很明顯:讀同一份資料時,DeepSeek V4 Pro 最果斷,Qwen 3.8 Max 最謹慎,Kimi K3 最常和大家唱反調。 DeepSeek、Qwen、Kimi 的比較,是在檢驗每個大型語言模型(LLM)如何把完全相同的市場資料轉成觀點、信心分數和操作計畫。在 2026 年 11 月 17–19 日資料上的 11 次 PickSkill 多模型會診中,DeepSeek 平均信心分數 3.36(滿分 5),而且一次都沒有看多;Qwen 平均 2.60,從未超過 3。
這是行為比較,不是準確率排名。這些分析才過了幾天,還沒有結果可以評分;11 次執行(53 則模型觀點)也只是很小的樣本。資料能告訴我們的,是在其他條件完全一致時,模型之間有什麼不同。
重點整理
- 同樣的輸入,不同的性格。 每次執行時五個模型讀的是同一份資料。DeepSeek V4 Pro 在 11 次中 7 次看空、0 次看多;MiniMax M2.5 有 6 次維持中性。
- 信心分數差距不大,但確實存在。 DeepSeek 在 11 則觀點中有 5 則給了 4 分;Qwen 每次都只給 2 或 3 分。沒有模型用過 1 分或 5 分。
- Kimi K3 最常唱反調。 它兩次成為唯一的異議者,也是唯一看多 600674.SS 的模型。DeepSeek 同樣兩次獨排眾議。
- 穩定性和速度各不相同。 Qwen 有一次沒有交卷(觸發 170 秒逾時),回應時間中位數最慢,為 107 秒;MiniMax 中位數只要 10 秒。
- 同一檔股票跑兩次,結論會變。 NVDA 在完全相同的資料上跑了兩次;兩次都作答的四個模型裡,三個改變了立場。
- 不是準確率排名。 樣本只有 11 次,尚無結果。請把它理解為「各模型的行為方式」,而不是「哪個模型說得對」。
我們到底比較了什麼?
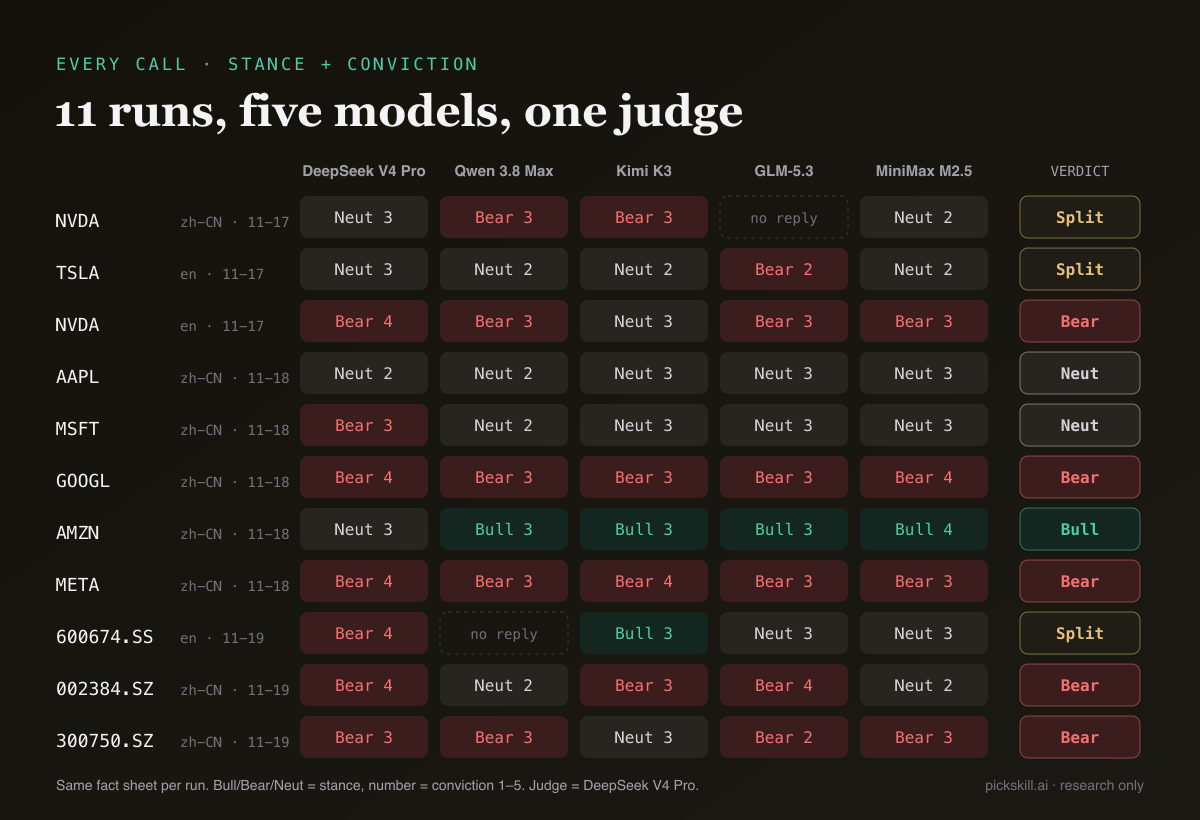
我們比較的是 PickSkill 多模型會診上的五個 LLM:DeepSeek V4 Pro、Qwen 3.8 Max、Kimi K3、GLM-5.3 和 MiniMax M2.5。每次執行時,所有模型拿到同一檔股票的同一份 JSON 資料表:近期價格走勢、八個技術指標(MACD、均線、RSI、KDJ、布林通道、ADX、成交量、資金流向)及各自的 5 日訊號軌跡、估值指標與最新財報。每個模型給出立場(看多、看空或中性)、1–5 分的信心分數、持有期間、理由、風險,以及只做多的操作策略。接著由 DeepSeek V4 Pro 擔任裁判,讀完所有觀點後做出結論(看多、看空、中性或分歧)。樣本是 2026 年 11 月 17–19 日儲存的全部執行紀錄:NVDA 兩次,TSLA、AAPL、MSFT、GOOGL、AMZN、META,以及三檔 A 股(600674.SS、002384.SZ、300750.SZ)。理論上應有 55 則觀點,實際收到 53 則。
為什麼相同的輸入才能公平比較?
只有輸入完全相同,輸出的差異才能歸因於模型本身。如果你分別在 DeepSeek、通義千問和 Kimi 自家的 App 裡問同一檔股票,它們上網搜尋的方式不同,看到的可能是不同日期的股價,系統提示詞不同,讀到的新聞也不同。這時出現分歧說明不了什麼:可能是資料不同,而不是推理不同。在多模型會診裡,同一次執行中每個模型拿到同一份資料表、同樣的指令(「只用提供的資料,絕不捏造數字」)和同樣的輸出格式,五個模型還是在同一時間並行呼叫。之後在立場、信心分數、所選價位上的差異,都來自模型本身。這種測試公平,但範圍有限:考的是對結構化資料的推理,而不是讀新聞或做估值。
DeepSeek、Qwen、Kimi 有什麼不同?
DeepSeek V4 Pro 最果斷也最偏空,Qwen 3.8 Max 最克制,Kimi K3 最獨立。DeepSeek 一次都沒有看多,11 則觀點是 7 則看空、4 則中性,平均信心分數 3.36,為五個模型中最高。Qwen 有 4 次給 2 分、6 次給 3 分,從未更高,平均 2.60 為最低。Kimi 看多次數最多(2 次),11 次中有 9 次信心分數為 3,還兩次成為唯一異議者:英文版 NVDA 和 300750.SZ 上,其餘四個模型都看空,只有它給中性。
| 模型 | 作答 | 看多 / 中性 / 看空 | 平均信心分數 | 與裁判一致* | 唯一異議 | 回應中位數 |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 11 / 11 | 0 / 4 / 7 | 3.36 | 6 / 8 | 2 | 56 秒 |
| Qwen 3.8 Max | 10 / 11 | 1 / 4 / 5 | 2.60 | 7 / 8 | 0 | 107 秒 |
| Kimi K3 | 11 / 11 | 2 / 5 / 4 | 3.00 | 6 / 8 | 2 | 50 秒 |
| GLM-5.3 | 10 / 11 | 1 / 3 / 6 | 2.90 | 8 / 8 | 1 | 58 秒 |
| MiniMax M2.5 | 11 / 11 | 1 / 6 / 4 | 2.91 | 7 / 8 | 0 | 10 秒 |
*只計算裁判給出明確方向的 8 次執行;另外 3 次為「分歧」。資料:PickSkill 多模型會診,基於 2026 年 11 月 17–19 日資料。
有兩個現象值得注意。第一,五個模型整體偏空(26 則看空、22 則中性、5 則看多),這主要反映輸入本身:不少股票正在下跌,截至 11 月 17 日收盤,NVDA 五日下跌 7.95%,收在 155.46。第二,持有期間這一項沒有區分度:53 則觀點全部選了「數週」,因為提示詞要求給出一到四週的觀點。想看一次完整執行的拆解,請讀五個 AI 模型分析 NVDA。
哪個模型最常和其他模型意見不同?
Kimi K3 和 DeepSeek V4 Pro 各有兩次在其他模型意見一致時獨排眾議,GLM-5.3 一次,Qwen 3.8 Max 和 MiniMax M2.5 一次都沒有。我們只在「其餘模型立場完全相同、只有這一個不同」時才計為一次唯一異議。DeepSeek 的兩次異議方向相反:MSFT 上其餘四個中性、它看空;AMZN 上其餘四個看多、它中性。GLM 唯一的一次是在 TSLA 上看空,而其餘四個都是中性。分歧最大的是 600674.SS(川投能源):Kimi 看多、DeepSeek 看空、GLM 和 MiniMax 中性,裁判判定為「分歧」。11 次中只有 3 次全體一致:AAPL(全部中性)、GOOGL 和 META(全部看空)。
異議不等於錯誤,它往往點出了多數人忽略的風險。例如 Kimi 在 NVDA 上給中性,依據是超賣讀數(RSI 約 22),而其他模型更看重下跌趨勢和資金流向。
裁判會偏袒 DeepSeek 嗎?
有可能,看「與裁判一致」這一欄時要記住這一點。裁判就是 DeepSeek V4 Pro,和其中一位分析師是同一個模型。關於「LLM 當裁判」的研究記錄過一種「自我強化」偏誤,也就是模型會偏好和自己相似的答案(Zheng 等,2023)。但在這 11 次執行中看不出這種效應:DeepSeek 自己的立場與結論一致 6/8 次,並列最低;GLM-5.3 則是 8/8。MSFT 上,裁判站在四個中性觀點這邊,而不是 DeepSeek 的看空;AMZN 上,裁判站在四個看多觀點這邊,而不是 DeepSeek 的中性。裁判也看得到投票統計,所以「與裁判一致」在某種程度上衡量的是與多數一致。
同一個模型問兩次,答案會一樣嗎?
不一定。NVDA 在同一份資料(11 月 17 日收盤 155.46)上跑了兩次,一次輸出中文,一次輸出英文。兩次都作答的四個模型中,三個改變了立場:DeepSeek 從中性(3)變成看空(4),Kimi 從看空(3)變成中性(3),MiniMax 從中性(2)變成看空(3)。只有 Qwen 兩次都是看空、信心分數 3。裁判結論也從「分歧」變成「看空」。只有一組樣本,無法判斷是輸出語言還是正常的抽樣隨機性造成的。無論是哪一種,一個模型的一次回答只是一個樣本,而不是一次測量。
怎麼自己比較 AI 模型的股票分析能力?
只要輸入完全相同,你可以用任何模型的輸出重現這套比較。我們的方法如下:
- 固定輸入。 給所有模型同一份標註日期的資料(每檔股票一份資料表)、同樣的指令和同樣的輸出格式。
- 收集結構化輸出。 把立場、1–5 分信心分數和持有期間設為欄位,這樣就能計數,而不必解讀大段文字。
- 記錄失敗。 記下哪個模型沒有作答、原因為何(本例中一次逾時、一次缺漏)。缺漏本身也是一種行為。
- 只計數,不評分。 按模型統計立場、平均信心分數、與最終結論一致的次數和唯一異議次數。
- 等結果出爐再排名。 準確率需要持有期間結束後的股價,最好涵蓋多次執行和不同的市場環境。
程式的核心部分,在匯出的執行紀錄上執行:
for run in runs:
    views, verdict = run["result"]["views"], run["result"]["summary"]["verdict"]
    for m in MODELS:
        if m not in views:
            missing[m].append(run["ticker"]); continue
        v = views[m]
        stance[m][v["stance"]] += 1; conviction[m].append(v["conviction"])
        if verdict != "split":
            judged[m] += 1; agree[m] += v["stance"] == verdict
        others = {views[o]["stance"] for o in views if o != m}
        if len(views) >= 3 and len(others) == 1 and v["stance"] not in others:
            lone[m] += 1
那麼,哪個 AI 模型最適合分析股票?
根據 11 次執行,誠實的答案是:取決於你想從模型那裡得到什麼,而準確率目前仍是未知數。想要果斷、價位明確的判斷,DeepSeek V4 Pro 押注最堅決。想要謹慎的第二意見,Qwen 3.8 Max 的信心分數很少超過 3,不過它最慢,還逾時過一次。Kimi K3 最可能挑戰共識。GLM-5.3 最貼近最終結論,MiniMax M2.5 則快得多。模型之間的分歧本身才是有用的訊號,這也是 PickSkill 多模型會診把五個觀點並排呈現、並附上裁判整理的共識與分歧的原因。想了解這如何融入更完整的研究流程,請看2026 年用 AI 做股票研究。
等足夠多的執行走完持有期間、可以用股價評分時,我們會再做一次比較。本文僅供研究與教育用途,不構成投資建議。
FAQ
DeepSeek 和通義千問,哪個分析股票比較好? 在基於 2026 年 11 月 17–19 日資料的 11 次執行中,DeepSeek V4 Pro 比 Qwen 3.8 Max 更果斷(平均信心分數 3.36 對 2.60),也更偏空,但目前還沒有結果能判斷誰比較準。「比較好」取決於你想要堅定還是謹慎的觀點,以及需要數週才能累積的準確率資料。
哪個大型語言模型最擅長分析股票? 以我們的資料來看,還沒有哪個大型語言模型被證明穩定最好。在輸入相同的情況下,五個模型的差異主要在信心分數、唱反調的頻率、穩定性和速度。用同一份資料比較多個模型、看它們在哪裡達成一致,比只相信一個模型的回答更有參考價值。
為什麼同一個 AI 模型分析同一檔股票會給出不同答案? 大型語言模型的輸出帶有抽樣隨機性,同樣的輸入再跑一次可能得出不同立場。在我們的資料中,NVDA 在相同資料上分析了兩次,四個模型中有三個改變了立場。請把任何一次 AI 回答都當作一個樣本,去看多個模型或多次執行之間是否一致。
PickSkill 多模型會診的最終結論是怎麼產生的? 由 DeepSeek V4 Pro 擔任裁判。它閱讀五位分析師的觀點和依信心分數加權的投票,然後給出結論(看多、看空、中性或分歧)、主要共識與分歧、只做多的策略,以及接下來要觀察的訊號。免費帳戶每月可執行一次多模型會診;當天已有人分析過的股票可以免費查看。
能看到這些統計背後的完整分析嗎? 可以。NVDA 那次執行的完整解讀請見我們的文章《五個 AI 模型分析 NVDA》。登入後,你也可以在多模型會診頁面親自分析美股、港股、A 股、日股和韓股,查看每個模型的理由、風險和價位。