DeepSeek vs Qwen vs Kimi para analizar acciones
DeepSeek, Qwen, Kimi, GLM y MiniMax leyeron los mismos datos de 11 acciones. Cómo difirieron su postura, convicción y disenso, con el método.
Con los datos actuales no hay un "mejor" modelo de IA para analizar acciones, pero sí diferencias claras de comportamiento: con la misma ficha de datos, DeepSeek V4 Pro fue el más tajante, Qwen 3.8 Max el más prudente y Kimi K3 el que más se apartó del grupo. Una comparación DeepSeek vs Qwen vs Kimi es una prueba de cómo cada modelo de lenguaje grande (LLM) convierte datos de mercado idénticos en una postura, una puntuación de convicción y un plan. En 11 ejecuciones del Panel de IA de PickSkill con datos del 17 al 19 de noviembre de 2026, DeepSeek promedió una convicción de 3,36 sobre 5 y no emitió ninguna opinión alcista; Qwen promedió 2,60 y nunca pasó de 3.
Es una comparación de comportamiento, no un ranking de acierto. Las ejecuciones tienen pocos días, así que aún no hay resultados que puntuar, y 11 ejecuciones (53 opiniones de modelos) son una muestra pequeña. Lo que sí muestran los datos es en qué se diferencian los modelos cuando todo lo demás es igual.
Puntos clave
- Mismos datos, distinto temperamento. Los cinco modelos leen una única ficha por ejecución. DeepSeek V4 Pro fue bajista en 7 de 11 ejecuciones y alcista en 0; MiniMax M2.5 se quedó neutral en 6 de 11.
- La diferencia de convicción es pequeña pero real. DeepSeek puso convicción 4 en 5 de sus 11 opiniones; Qwen puso 2 o 3 siempre. Nadie usó 1 ni 5.
- Kimi K3 es el que más disiente. Fue el único discrepante dos veces y el único modelo alcista en 600674.SS. DeepSeek también disintió en solitario dos veces.
- La fiabilidad y la velocidad varían. Qwen falló una ejecución (alcanzó el límite de 170 segundos) y tuvo la respuesta mediana más lenta, 107 s; MiniMax respondió en una mediana de 10 s.
- La misma acción, dos veces, dio opiniones distintas. NVDA se analizó dos veces con datos idénticos; tres de los cuatro modelos que respondieron ambas veces cambiaron de postura.
- No es un ranking de acierto. n = 11 ejecuciones, sin resultados todavía. Léelo como "cómo se comporta cada modelo", no como "qué modelo acierta".
¿Qué comparamos exactamente?
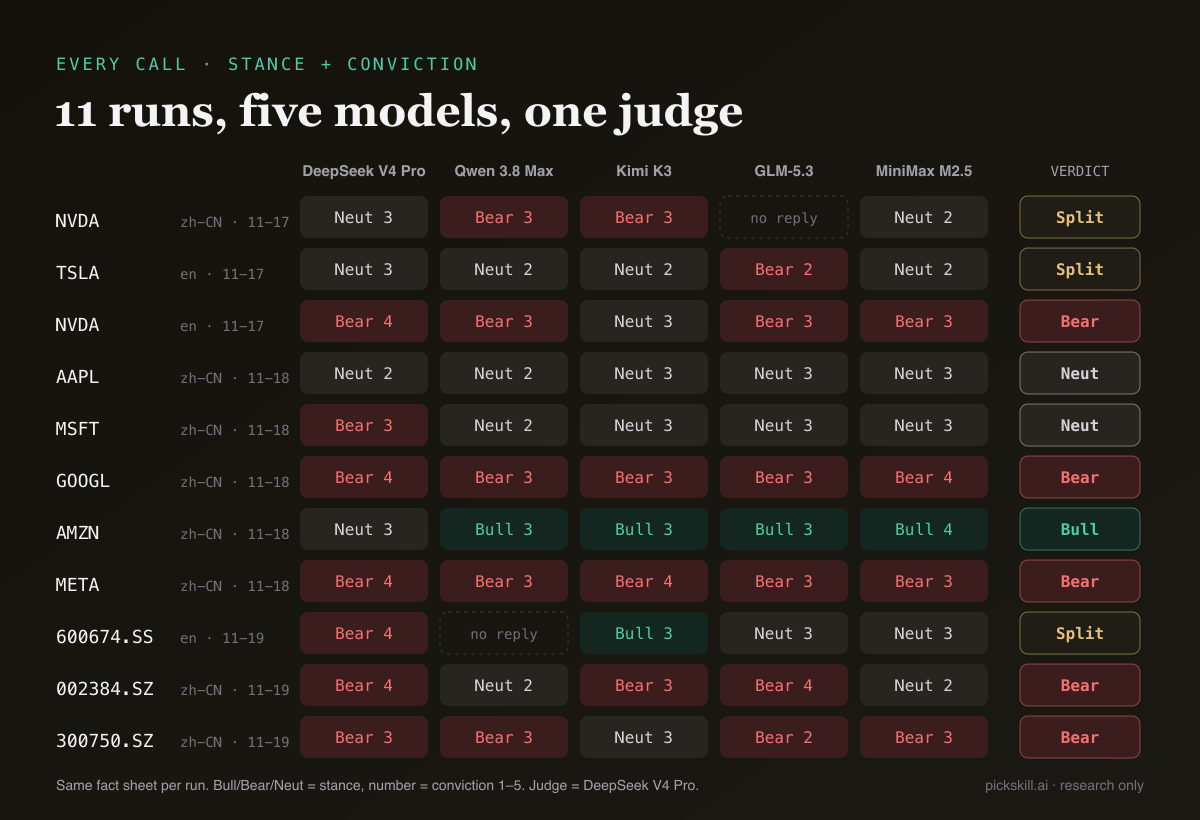
Comparamos los cinco LLM del Panel de IA de PickSkill: DeepSeek V4 Pro, Qwen 3.8 Max, Kimi K3, GLM-5.3 y MiniMax M2.5. En cada ejecución, todos reciben la misma ficha JSON de una acción: evolución reciente del precio, ocho señales técnicas (MACD, medias móviles, RSI, KDJ, Bandas de Bollinger, ADX, volumen y flujo de dinero), cada una con su historial de 5 días, ratios de valoración y los últimos resultados. Cada modelo devuelve una postura (alcista, bajista o neutral), una convicción de 1 a 5, un horizonte, motivos, riesgos y una estrategia solo en largo. Después, DeepSeek V4 Pro actúa como árbitro: lee todas las opiniones y emite un veredicto (alcista, bajista, neutral o dividido). La muestra son todas las ejecuciones guardadas del 17 al 19 de noviembre de 2026: NVDA dos veces, TSLA, AAPL, MSFT, GOOGL, AMZN, META y tres acciones A de China (600674.SS, 002384.SZ, 300750.SZ). Eso da 55 opiniones posibles; llegaron 53.
¿Por qué hacen falta datos idénticos para una comparación justa?
Solo con datos idénticos se puede atribuir una diferencia en la respuesta al propio modelo. Si preguntas por una acción a DeepSeek, Qwen y Kimi en sus propias apps de chat, cada uno puede buscar en la web de forma distinta, ver precios de días diferentes, recibir otro prompt de sistema y leer otras noticias. Un desacuerdo entonces dice poco: puede deberse a los datos y no al razonamiento. En el panel, todos los modelos de una ejecución reciben la misma ficha, las mismas instrucciones ("usa solo los datos proporcionados, nunca inventes cifras") y el mismo formato de salida, y los cinco se llaman en paralelo en el mismo momento. Lo que varíe a partir de ahí, como la postura, la convicción o los niveles de precio elegidos, viene del modelo. La prueba es justa pero acotada: mide el razonamiento sobre datos estructurados, no la lectura de noticias ni la valoración.
¿En qué se diferenciaron DeepSeek, Qwen y Kimi?
DeepSeek V4 Pro fue el más tajante y el más bajista, Qwen 3.8 Max el más contenido y Kimi K3 el más independiente. DeepSeek nunca calificó una acción de alcista; sus 11 opiniones se repartieron en 7 bajistas y 4 neutrales, con una convicción media de 3,36, la más alta de los cinco. Qwen usó convicción 2 en cuatro opiniones y 3 en seis, nunca más, y obtuvo la media más baja (2,60). Kimi tuvo más opiniones alcistas (2), se quedó en convicción 3 en 9 de 11 y fue el único discrepante dos veces: neutral en la ejecución de NVDA en inglés y en 300750.SZ mientras los otros cuatro eran bajistas.
| Modelo | Opiniones | Alcista / Neutral / Bajista | Convicción media | Coincide con el árbitro* | Único discrepante | Respuesta mediana |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 11 / 11 | 0 / 4 / 7 | 3,36 | 6 / 8 | 2 | 56 s |
| Qwen 3.8 Max | 10 / 11 | 1 / 4 / 5 | 2,60 | 7 / 8 | 0 | 107 s |
| Kimi K3 | 11 / 11 | 2 / 5 / 4 | 3,00 | 6 / 8 | 2 | 50 s |
| GLM-5.3 | 10 / 11 | 1 / 3 / 6 | 2,90 | 8 / 8 | 1 | 58 s |
| MiniMax M2.5 | 11 / 11 | 1 / 6 / 4 | 2,91 | 7 / 8 | 0 | 10 s |
*Contado solo en las 8 ejecuciones en las que el árbitro dio una dirección; 3 fueron "divididas". Datos: ejecuciones del Panel de IA de PickSkill con datos del 17 al 19 de noviembre de 2026.
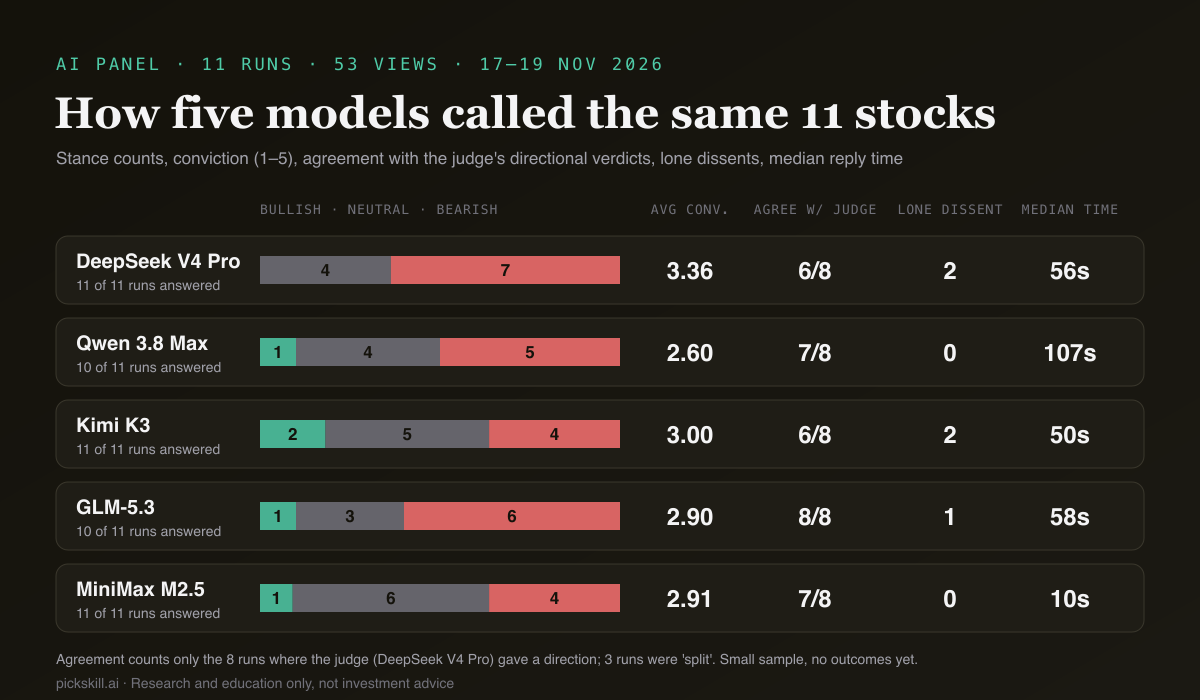
Destacan dos patrones. Primero, el panel en conjunto se inclinó a la baja (26 opiniones bajistas, 22 neutrales y 5 alcistas), algo que refleja sobre todo los datos de entrada: muchas de estas acciones estaban cayendo, y NVDA bajaba un 7,95 % en cinco días hasta 155,46 al cierre del 17 de noviembre. Segundo, el horizonte no aportó nada: las 53 opiniones eligieron "semanas", porque el prompt pide una visión de una a cuatro semanas. Para ver una ejecución completa, lee cinco modelos de IA analizan NVDA.
¿Qué modelo discrepó más a menudo de los demás?
Kimi K3 y DeepSeek V4 Pro rompieron dos veces cada uno un panel por lo demás unánime, GLM-5.3 una vez y Qwen 3.8 Max y MiniMax M2.5 ninguna. Solo contamos un "disenso en solitario" cuando todos los demás modelos de la ejecución comparten una misma postura y este tiene otra. Los dos disensos de DeepSeek fueron en sentidos opuestos: bajista en MSFT cuando los otros cuatro eran neutrales, y neutral en AMZN cuando los otros cuatro eran alcistas. El único de GLM fue bajista en TSLA frente a cuatro neutrales. La ejecución más dividida fue 600674.SS (Sichuan Chuantou Energy): Kimi alcista, DeepSeek bajista, GLM y MiniMax neutrales, y el árbitro dictó "dividido". Solo 3 de 11 ejecuciones fueron unánimes: AAPL (todos neutrales), GOOGL y META (todos bajistas).
Discrepar no es equivocarse; a menudo el disenso señala un riesgo que la mayoría pasó por alto. La opinión neutral de Kimi sobre NVDA, por ejemplo, se apoyaba en lecturas de sobreventa (RSI cerca de 22), mientras los demás pesaban más la tendencia bajista y el flujo de dinero.
¿Está el árbitro sesgado a favor de DeepSeek?
Podría estarlo, y conviene tenerlo en cuenta al leer la columna "coincide con el árbitro". El árbitro es DeepSeek V4 Pro, el mismo modelo que uno de los panelistas. La investigación sobre LLM que actúan como jueces ha documentado un sesgo de "autofavorecimiento" (self-enhancement), por el que un modelo prefiere respuestas parecidas a las suyas (Zheng et al., 2023). En nuestras 11 ejecuciones el efecto no se aprecia: la postura de DeepSeek coincidió con el veredicto 6 de 8 veces, empatada en la tasa más baja, mientras GLM-5.3 coincidió 8 de 8. En MSFT el árbitro se puso del lado de las cuatro opiniones neutrales frente a la bajista de DeepSeek, y en AMZN del de las cuatro alcistas frente a la neutral de DeepSeek. El árbitro también ve el recuento de votos, así que "coincidir con el árbitro" mide en parte coincidir con la mayoría.
¿Da el mismo modelo la misma respuesta dos veces?
No de forma fiable. NVDA se analizó dos veces con la misma ficha (cierre del 17 de noviembre, 155,46), una con salida en chino y otra en inglés. De los cuatro modelos que respondieron ambas veces, tres cambiaron de postura: DeepSeek pasó de neutral (3) a bajista (4), Kimi de bajista (3) a neutral (3) y MiniMax de neutral (2) a bajista (3). Solo Qwen se mantuvo bajista con convicción 3 las dos veces. El árbitro pasó de "dividido" a "bajista". Con un solo par no podemos saber si el cambio se debe al idioma de salida o a la aleatoriedad normal del muestreo. En cualquier caso, una respuesta de un modelo es una muestra, no una medición.
¿Cómo puedes comparar tú mismo modelos de IA para analizar acciones?
Puedes reproducir esta comparación con las respuestas de cualquier modelo, siempre que los datos de entrada sean idénticos. Este es el método que usamos:
- Fija la entrada. Da a todos los modelos los mismos datos fechados (una ficha por acción), las mismas instrucciones y el mismo formato de salida.
- Recoge respuestas estructuradas. Exige la postura, una convicción de 1 a 5 y un horizonte como campos, para poder contarlos en lugar de interpretar texto.
- Registra los fallos. Anota qué modelo no respondió y por qué (aquí: un tiempo de espera agotado y una respuesta ausente). La ausencia también es un comportamiento.
- Cuenta, no puntúes. Suma por modelo las posturas, la convicción media, las coincidencias con el veredicto final y los disensos en solitario.
- Espera a los resultados antes de clasificar. El acierto requiere precios posteriores al fin del horizonte, idealmente en muchas ejecuciones y distintos regímenes de mercado.
El núcleo de nuestro script, ejecutado sobre las ejecuciones exportadas:
for run in runs:
    views, verdict = run["result"]["views"], run["result"]["summary"]["verdict"]
    for m in MODELS:
        if m not in views:
            missing[m].append(run["ticker"]); continue
        v = views[m]
        stance[m][v["stance"]] += 1; conviction[m].append(v["conviction"])
        if verdict != "split":
            judged[m] += 1; agree[m] += v["stance"] == verdict
        others = {views[o]["stance"] for o in views if o != m}
        if len(views) >= 3 and len(others) == 1 and v["stance"] not in others:
            lone[m] += 1
Entonces, ¿cuál es el mejor modelo de IA para analizar acciones?
Con 11 ejecuciones, la respuesta honesta es que depende de lo que esperes del modelo, y el acierto todavía es desconocido. Si quieres una lectura tajante con niveles claros, DeepSeek V4 Pro fue el que más se comprometió. Si buscas una segunda opinión prudente, Qwen 3.8 Max casi nunca superó la convicción 3, aunque fue el más lento y agotó el tiempo una vez. Kimi K3 es el más propenso a cuestionar el consenso. GLM-5.3 quedó más cerca del veredicto final y MiniMax M2.5 fue, con diferencia, el más rápido. La dispersión entre ellos es la señal útil, y por eso el Panel de IA de PickSkill muestra las cinco opiniones lado a lado con los acuerdos y desacuerdos que resume el árbitro. Para ver cómo encaja en un flujo más amplio, consulta nuestra guía de IA para analizar acciones en 2026.
Repetiremos la comparación cuando suficientes ejecuciones hayan superado su horizonte para puntuarlas con precios. Contenido solo con fines de investigación y formación, no es asesoramiento de inversión.
FAQ
¿Es DeepSeek mejor que Qwen para analizar acciones? En nuestras 11 ejecuciones con datos del 17 al 19 de noviembre de 2026, DeepSeek V4 Pro fue más tajante (convicción media 3,36 frente a 2,60) y más bajista que Qwen 3.8 Max, pero aún no hay resultados para saber cuál acertó más. "Mejor" depende de si prefieres una opinión firme o una prudente, y de datos de acierto que tardarán semanas en llegar.
¿Qué LLM es el mejor para analizar acciones? Con nuestros datos, ningún LLM ha demostrado todavía ser el mejor de forma consistente. Con datos idénticos, los cinco modelos probados se diferenciaron sobre todo en convicción, frecuencia de disenso, fiabilidad y velocidad. Comparar varios modelos con la misma ficha y ver en qué coinciden es más informativo que fiarse de la respuesta de uno solo.
¿Por qué el mismo modelo de IA da respuestas distintas sobre la misma acción? Los modelos de lenguaje generan su respuesta por muestreo, así que la misma entrada puede producir otra postura en una nueva ejecución. En nuestros datos, NVDA se analizó dos veces con cifras idénticas y tres de cuatro modelos cambiaron de postura. Trata cada respuesta de una IA como una muestra y busca coincidencias entre modelos o ejecuciones.
¿Cómo decide el Panel de IA de PickSkill el veredicto final? DeepSeek V4 Pro actúa como árbitro. Lee las opiniones de los cinco analistas y el voto ponderado por convicción, y redacta un veredicto (alcista, bajista, neutral o dividido), los principales acuerdos y desacuerdos, una estrategia solo en largo y qué vigilar después. Las cuentas gratuitas tienen una ejecución del Panel de IA al mes; una acción que alguien ya analizó ese día se carga gratis.
¿Puedo ver los análisis completos detrás de estas estadísticas? Sí. La ejecución de NVDA se explica en nuestro artículo sobre cinco modelos de IA que analizan NVDA. Tras iniciar sesión, también puedes lanzar el panel desde la página del Panel de IA sobre acciones de EE. UU., Hong Kong, China A, Japón y Corea, y ver los motivos, riesgos y niveles de precio de cada modelo.