AIは株を選べるのか?2026年の公開実験の結論
ChatGPT・Gemini・DeepSeek などによる AI 銘柄選びの公開実験の結果、同じモデルでも回答が毎回変わる理由、そしてより堅実な AI の使い方を解説。
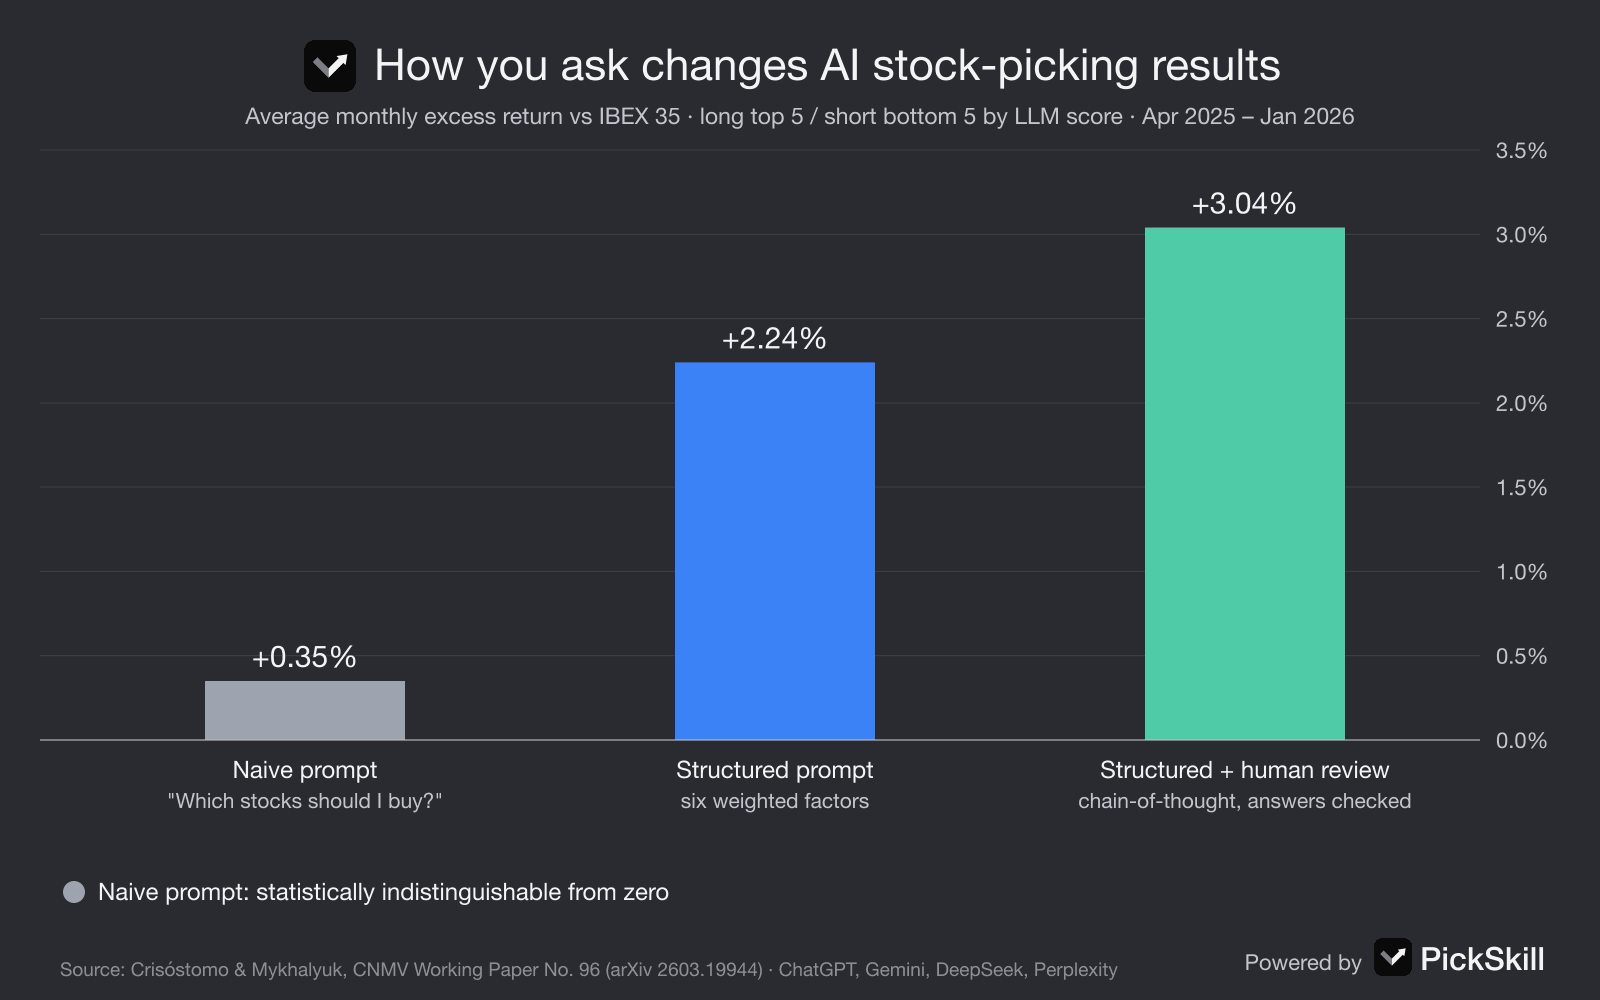
AI は株式リサーチの役には立ちますが、チャットボットが単独で安定して勝ち銘柄を選べるという公開データはまだありません。AI による銘柄選び(AI stock picking)とは、ChatGPT・Gemini・DeepSeek などの大規模言語モデル(LLM)に、市場を上回りそうな銘柄を選ばせたり順位付けさせたりすることです。スペイン証券市場委員会(CNMV)が 2026 年 3 月に公表したワーキングペーパー第 96 号は IBEX 35 銘柄で 10 か月のライブ検証を行い、「どの株を買うべき?」という単純な質問では月平均の超過リターンが 0.35% にとどまり、統計的にゼロと区別できないと結論づけました。
プロンプトを構造化し、人間が推論をチェックすると結果は大きく改善しました。2025〜2026 年のほかの公開テストも同じ方向を示しています。結果はまちまちで、聞き方に大きく左右され、1 つのモデルの 1 回の回答は「お告げ」として扱えるほど安定していません。
要点
- エビデンスはまちまち。 後述の 4 つの公開実験では、ベンチマークを上回った AI ポートフォリオもあれば下回ったものもあり、検証期間は 6〜10 か月と短いものが中心です。
- どう聞くかは、どのモデルに聞くかと同じくらい重要。 CNMV の研究では、月平均超過リターンが 0.35%(素朴な質問)から 2.24%(構造化プロンプト)、3.04%(構造化+人によるレビュー)へと上昇しました。
- 1 モデル・1 回の回答はノイズが大きい。 CNMV の著者は「出力の不安定さ」(同一プロンプトで異なる出力)を繰り返し起きる失敗として挙げています。私たちの AI Panel も、同じデータで約 70 分の間隔を置いて NVDA を分析したところ、「意見分裂」の後に「弱気」という判定を出しました。
- モデルには共通の盲点がある。 研究ではテック株・大型株への偏りが見つかっており、ハーバードの研究では、中国のネガティブニュースが欠けていたために ChatGPT が DeepSeek より中国株に楽観的でした。
- AI はリサーチとセカンドオピニオンに使い、 独立した複数のモデルを比べて、意見が割れる点を読み解きましょう。
AI は本当に市場に勝つ銘柄を選べるのか?
これまでに公表された研究を見る限り、AI 単独では当てになりません。最も厳密な公開テストは、スペインの証券規制当局に所属する Ricardo Crisóstomo 氏と Diana Mykhalyuk 氏による CNMV ワーキングペーパー第 96 号「Large Language Models and Stock Investing: Is the Human Factor Required?」です。2025 年 4 月から 2026 年 1 月まで、毎月最初の取引日に ChatGPT・Gemini・DeepSeek・Perplexity に IBEX 35 の全 35 銘柄をスコアリングさせ、上位 5 銘柄を買い・下位 5 銘柄を売るロング・ショートのポートフォリオで検証しました。素朴な質問の月平均超過リターンは 0.35% で、統計的にゼロと区別できません。6 つの加重ファクターを指定した構造化プロンプトでは 2.24%、各回答を人がレビューする思考連鎖(chain-of-thought)プロンプトでは 3.04% に達しました。著者の結論は、誘導と監督があれば LLM は「市場を上回る力がある」が、その超過リターンは自律的な運用では「自動的でも頑健でもない」というものです。
公開された AI 銘柄選び実験で何がわかったか?
2025〜2026 年の 4 つの公開テストは、市場もモデルも設定もそれぞれ異なり、どれも結論を出せるほど長くはありません。まとめて見ると、結果はモデル・リスク水準・期間によって大きく振れ、良い結果ほど構造化や人の監督を伴っています。
| 実施者 | モデル | 市場と期間 | 結果 |
|---|---|---|---|
| CNMV ワーキングペーパー第 96 号 | ChatGPT、Gemini、DeepSeek、Perplexity | IBEX 35、2025 年 4 月〜2026 年 1 月、月次 | 素朴な質問:月 0.35%(有意でない)。構造化:2.24%。人の監督付き:3.04%、4 モデルすべて有意 |
| Finder の AI ポートフォリオ対決 | ChatGPT、Gemini、Copilot、DeepSeek、Perplexity、Meta AI、Grok | 各モデル 10 銘柄×4 ポートフォリオ、2026 年 1〜12 月(10 月までの結果) | 積極型はすべてマイナスで、2 つのベンチマークをいずれも下回った。保守型では DeepSeek が 15.11% で首位 |
| Dezerv | Grok、ChatGPT、Gemini、Perplexity、Claude | インド株、Nifty 500 TRI と比較、2025 年 8 月 4 日開始(6 か月時点) | Gemini と Perplexity が上回り、Grok と ChatGPT が下回り、Claude はほぼ市場並み。筆者は偶然のばらつきの可能性が高いとする |
| ハーバード・ビジネス・スクール(Wang、Cao、Xiang) | ChatGPT 4.1、DeepSeek R1 | 上海・深圳の 4,978 銘柄、2024 年 12 月 31 日の株価を予測 | ChatGPT の予測株価は DeepSeek より約 12.5% 高く、絶対誤差は 13% 大きかった |
Finder は 2026 年 10 月の更新で、このテストが「比較的短い期間」しかカバーしていないと注意書きしています。Dezerv の記事はモデルを「規律あるポートフォリオマネージャーではなく、確率的なブレインストーマー」と呼び、実力を示すには異なる相場サイクルを通じて一貫したリスク調整後リターンが必要だと述べています。HBS の研究はポートフォリオではなく予測テストですが、学習データがすべての回答を一方向に傾けうることを示しています。
なぜ AI の推奨銘柄は聞くたびに変わるのか?
LLM はサンプリングによって回答を生成するため、同じ質問でも強調点や銘柄、結論まで変わることがあります。Web 検索のやり方も毎回違います。CNMV 論文の推論失敗の分類には、「検索の不安定さ」(ある質問では数十の情報源を参照し、似た質問では 2 つだけ)や「出力の不安定さ」(0.75 と算出したスコアが同等のプロンプトで変わる)のほか、古いデータ、捏造された数値、通貨の混同、計算ミスが含まれます。Dezerv の筆者も、モデルは非決定的で、月ごとの説明責任を持たないと指摘しています。投資家にとって、チャットの 1 回の回答は幅のある回答のうちの 1 サンプルにすぎず、どれを引いたのかは回答自体からはわかりません。
私たちのデータでも同じことが起きました。PickSkill の AI Panel は、DeepSeek V4 Pro・Qwen 3.8 Max・Kimi K3・GLM-5.3・MiniMax M2.5 の 5 モデルに同じ銘柄ファクトシートを読ませ、ジャッジモデルが見解を集計します。2026 年 11 月 19 日、11 月 17 日終値(155.46 ドル)時点の同じデータで、約 70 分の間隔を置いて NVDA を 2 回分析しました。1 回目は中国語、2 回目は英語でリクエストし、1 回目は GLM の見解が返ってこなかったため、厳密な対照実験ではありません。それでも結果は示唆的です。
- 1 回目(02:21 UTC): Qwen と Kimi が弱気、DeepSeek と MiniMax が中立。集計スコア −0.55、判定は意見分裂。ジャッジの戦略は、148.35〜155.46 のサポートゾーンで小さく打診し、148 割れで損切り。
- 2 回目(03:31 UTC): GLM・Qwen・MiniMax・DeepSeek が弱気、Kimi が中立。集計スコア −0.81、判定は弱気。ジャッジの戦略は、新規の買いを避け、162.87 付近への戻りで持ち高を減らす。
- 変わった点: 両方で回答した 4 モデルのうち 3 つがスタンスを変えました。Kimi は弱気から中立へ、DeepSeek と MiniMax は中立から弱気へ。Qwen だけが同じ見解でした。
- 変わらなかった点: どちらの回も重要な事実――強い下降トレンド、売られすぎのオシレーター、148.35 付近のサポート――では一致し、全体としてネガティブ寄りでした。
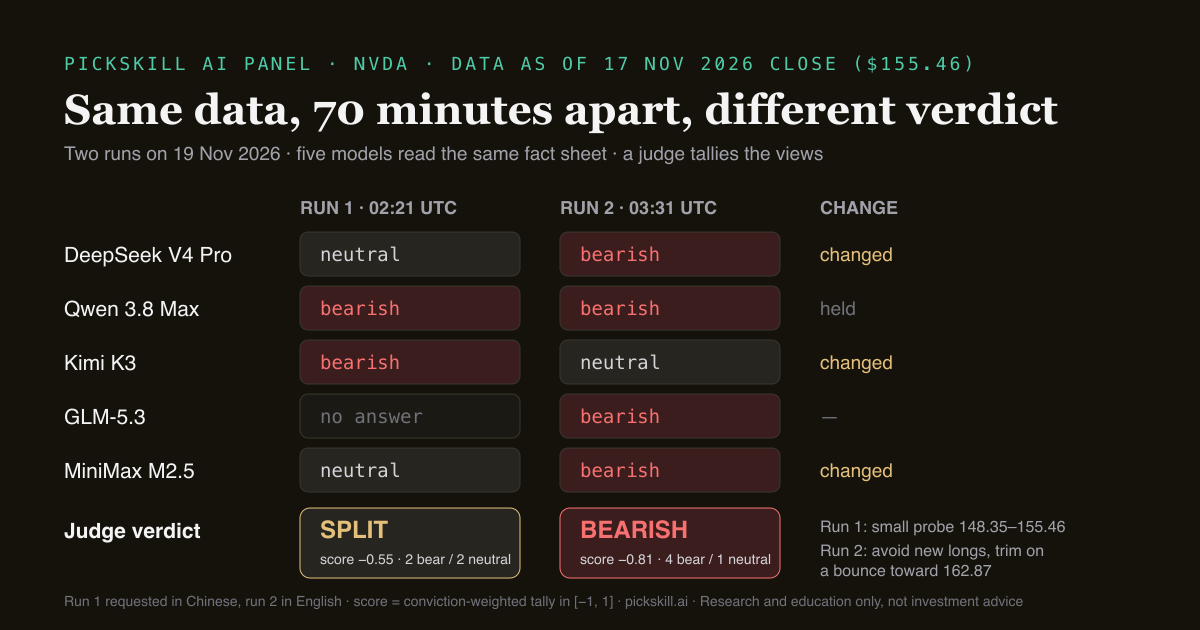
方向は安定していましたが、確信度と行動は安定していませんでした。どちらか一方の回答だけを見ていたら、「反発を打診する」と「避ける」のどちらにも同じくらいの自信を持って行き着いたかもしれません。
AI モデルはどれも同じ大型株を選ぶのか?
しばしばそうなります。そしてそれは裏付けではなくリスクです。Hoyoung Lee 氏らによる LLM の投資バイアスの研究(arXiv 2507.20957)は、検証したほとんどのモデルで「テクノロジー株、大型株、逆張り戦略を好む傾向が見られる」と報告し、こうした選好が確証バイアスへと固まりうると指摘しています。複数のチャットボットが同じ一握りの超大型株を勧めるとき、それは独立した結論ではなく、同じ学習データやニュース報道を繰り返しているだけかもしれません。HBS の研究では、中国語のニュースを加えると ChatGPT の中国企業への楽観が消えました。偏りはモデルが何を読んだかに由来していたのです。Dezerv の筆者も、多くの利用者が同じ AI 推奨銘柄に集中するリスクを警告しています。モデル同士の一致に意味があるのは、モデルが互いに独立し、検証済みの同じ事実に基づいているときだけです。
では AI を株式リサーチにどう使えばよいか?
AI は銘柄を選ぶ機械ではなく、速いリサーチアシスタントでありセカンドオピニオンとして扱いましょう。CNMV の結果が示すシンプルな原則は、構造・検証済みデータ・明確なタスクをモデルに与え、行動する前に推論をチェックすることです。
- 記憶ではなくデータに基づかせる。 モデルが覚えていることではなく、日付入りのファクトシート――値動き、シグナル、バリュエーション、直近決算――を基に考えさせます。CNMV の研究では、公式の規制開示資料が予測精度を高めました。
- 構造化を求める。 「買いですか?」ではなく、スタンス、時間軸、理由、リスク、考えを変える条件を求めます。どの情報がどちらに属するかはテクニカル分析とファンダメンタル分析の違いをご覧ください。
- 複数回、複数モデルに聞く。 同じ質問を独立した複数のモデルに投げ、見解の散らばりを確認します。
- まず意見の相違を読む。 モデルの意見が割れる点こそ、サポート水準、決算リスク、バリュエーション判断など、本当の不確実性がある場所です。
- 最後は自分のリスクルールで決める。 あなたの投資期間、ポジションサイズ、税務状況を知っているモデルはありません。
PickSkill は手順 1・3・4 を 1 つの画面にまとめています。AI Panel は 5 つのモデルに同じファクトシートを読ませ、−1〜+1 の確信度加重スコアと各モデルのスタンス・理由・リスクを表示します。ジャッジは一致点と相違点を挙げ、強気・弱気・中立・意見分裂の 4 つの判定のいずれかを返します。2026 年 11 月 17〜19 日の 11 回の実行で、5 モデルの意見が完全に一致したのは 3 銘柄だけでした(GOOGL と META が弱気、AAPL が中立)。自由な質問には、シグナルと決算データを会話に取り込む AI アナリストチャットが使えます。ツール全体については 2026 年版 AI 株式リサーチガイドをご覧ください。
AI の銘柄選びにまだできないことは?
AI は未来を見通せず、データが最新である保証もなく、自分がどれだけ確信すべきかも言えません。公開テストはいずれも 6〜10 か月と短く、特定の市場と、数か月ごとに更新されるモデルのバージョンが対象です。CNMV 論文は、データ取得、財務指標の解釈、計算で繰り返し誤りが起きることを示しており、こうした誤りは単純な質問に頼りがちな投資家ほど見抜きにくいものです。私たちの 11 回の AI Panel 実行はリターンについて何かを語るには少なすぎ、回答のふるまいを示すにすぎません。AI はチェックを省くためではなく、チェックの範囲を広げるために使いましょう。本記事は調査・教育目的のみであり、投資助言ではありません。
FAQ
ChatGPT の銘柄選びは当たりますか? 公開データはまちまちです。CNMV ワーキングペーパー第 96 号では、ChatGPT への単純な会話型の質問は IBEX 35 銘柄でマイナスの超過リターンとなり、構造化や人の監督を加えると大きく改善しました。Finder の 2026 年の対決では、積極型ポートフォリオが 2026 年 10 月時点で 13.09% のマイナスでした。ChatGPT は単独の銘柄選びより、決算資料の解説やリサーチの整理に向いています。
市場に勝った AI はありますか? 短期間でベンチマークを上回った AI ポートフォリオはあります。CNMV の研究では 4 モデルすべてが統計的に有意な超過リターンを出しましたが、それは構造化プロンプトとすべての回答への人のレビューがあった場合だけです。Finder の保守型 AI ポートフォリオは 2026 年 10 月までにほとんどがベンチマークを上回った一方、積極型はすべて下回りました。持続的な実力を証明できるほど長いテストはありません。
AI に聞くたびに推奨銘柄が変わるのはなぜですか? LLM は回答をサンプリングで生成し、Web 検索のやり方もリクエストごとに異なるため、同じプロンプトでも銘柄やスコア、スタンスが変わることがあります。CNMV 論文はこの「出力の不安定さ」を繰り返し起きる失敗に挙げています。PickSkill の AI Panel も、同じデータで約 70 分の間に NVDA の判定が「意見分裂」から「弱気」に変わりました。
1 つより複数の AI モデルに聞くほうがよいですか? 同じ検証済みデータを読んだ独立した複数のモデルに聞くほうが、1 つの回答を信じるより堅実です。どこで一致し、どこで割れるかが見えるからです。ただし、大型テック株への偏りのような共通の学習バイアスがあると一致は弱い証拠にすぎないため、決める前に相違点とリスクを読みましょう。
AI はファイナンシャルアドバイザーや自分のリサーチの代わりになりますか? なりません。AI はリサーチを速め、決算資料を要約し、セカンドオピニオンを出せますが、あなたの目標や投資期間、リスク許容度は知らず、データや計算でも誤ります。HBS の Charles Wang 教授は、AI ツールは「リサーチを加速できるが、人間の判断の代わりにはならない」と述べています。