AI가 종목을 고를 수 있을까? 2026 실험 결과
ChatGPT·Gemini·DeepSeek 등 AI 종목 선정 공개 실험 결과, 같은 모델도 매번 답이 달라지는 이유, 그리고 AI를 더 안정적으로 쓰는 방법.
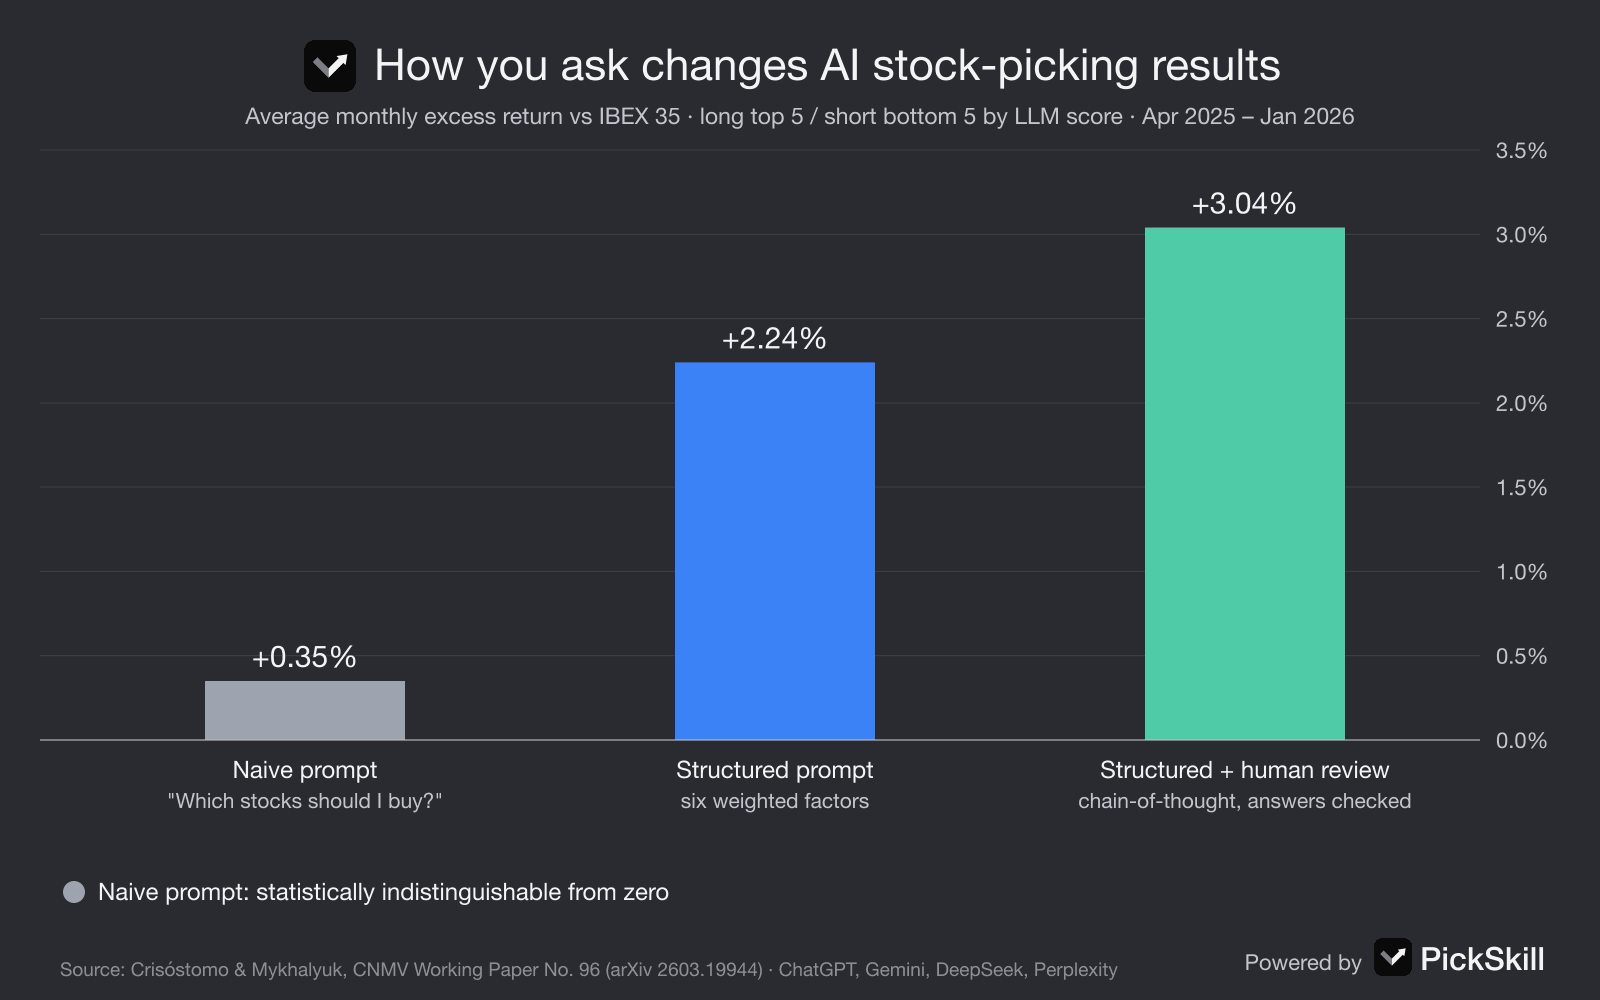
AI는 주식 리서치에 도움이 되지만, 챗봇이 혼자서 꾸준히 이기는 종목을 고른다는 공개 증거는 아직 없습니다. AI 종목 선정(AI stock picking)이란 ChatGPT, Gemini, DeepSeek 같은 대규모 언어 모델(LLM)에게 시장을 이길 것으로 보이는 종목을 고르거나 순위를 매기게 하는 것입니다. 스페인 증권시장위원회(CNMV)가 2026년 3월 발표한 워킹페이퍼 제96호는 IBEX 35 종목으로 10개월간 실시간 테스트를 했고, "어떤 주식을 사야 하나요?" 같은 단순한 질문의 월평균 초과수익률은 0.35%로 통계적으로 0과 구분되지 않았습니다.
프롬프트를 구조화하고 사람이 추론을 검토하자 결과가 크게 좋아졌습니다. 2025~2026년의 다른 공개 테스트도 같은 방향입니다. 결과는 엇갈리고, 질문 방식에 크게 좌우되며, 한 모델의 한 번의 답은 '신탁'처럼 믿을 만큼 안정적이지 않습니다.
핵심 요약
- 증거는 엇갈립니다. 아래 네 가지 공개 실험에서 벤치마크를 이긴 AI 포트폴리오도, 뒤처진 포트폴리오도 있었고, 기간은 대부분 6~10개월로 짧았습니다.
- 어떻게 묻느냐는 어떤 모델에 묻느냐만큼 중요합니다. CNMV 연구에서 월평균 초과수익률은 0.35%(단순 질문)에서 2.24%(구조화 프롬프트), 3.04%(구조화 + 사람 검토)로 올라갔습니다.
- 한 모델, 한 번의 답은 노이즈가 큽니다. CNMV 저자들은 '출력 불안정'(같은 프롬프트에 다른 출력)을 반복되는 실패로 꼽았습니다. 저희 AI Panel도 같은 데이터로 약 70분 간격을 두고 NVDA에 '의견 분열', 이어서 '약세' 판정을 내렸습니다.
- 모델들은 같은 사각지대를 공유합니다. 연구에 따르면 기술주와 대형주 쏠림이 있고, 하버드 연구에서는 중국의 부정적 뉴스가 빠져 있어 ChatGPT가 DeepSeek보다 중국 주식을 더 낙관했습니다.
- AI는 리서치와 세컨드 오피니언에 쓰고, 독립적인 여러 모델을 비교해 의견이 갈리는 지점을 읽으세요.
AI가 정말 시장을 이기는 종목을 고를 수 있나요?
지금까지 발표된 연구를 보면, AI 혼자서는 믿을 만하지 않습니다. 가장 엄격한 공개 테스트는 스페인 증권 규제 당국 소속 Ricardo Crisóstomo와 Diana Mykhalyuk의 CNMV 워킹페이퍼 제96호 "Large Language Models and Stock Investing: Is the Human Factor Required?"입니다. 이들은 2025년 4월부터 2026년 1월까지 매달 첫 거래일에 ChatGPT, Gemini, DeepSeek, Perplexity에게 IBEX 35 전체 35개 종목에 점수를 매기게 한 뒤, 상위 5개 매수·하위 5개 매도의 롱숏 포트폴리오로 검증했습니다. 단순 질문의 월평균 초과수익률은 0.35%로 통계적으로 0과 구분되지 않았습니다. 6개 가중 요인을 지정한 구조화 프롬프트는 2.24%, 모든 답을 사람이 검토한 사고 사슬(chain-of-thought) 프롬프트는 3.04%였습니다. 저자들의 결론은 안내와 감독이 있으면 LLM이 "시장을 이길 수 있지만", 그 초과수익은 자율적으로 운용할 때 "자동적이지도, 견고하지도 않다"는 것입니다.
공개된 AI 종목 선정 실험은 무엇을 발견했나요?
2025~2026년의 네 가지 공개 테스트는 시장, 모델, 설정이 모두 다르고, 어느 것도 결론을 내릴 만큼 길지 않습니다. 함께 보면 결과는 모델, 위험 수준, 기간에 따라 크게 흔들리고, 더 나은 결과는 더 많은 구조나 사람의 감독과 함께 나타납니다.
| 주체 | 모델 | 시장과 기간 | 결과 |
|---|---|---|---|
| CNMV 워킹페이퍼 제96호 | ChatGPT, Gemini, DeepSeek, Perplexity | IBEX 35, 2025년 4월~2026년 1월, 월별 | 단순 질문: 월 0.35%(유의하지 않음). 구조화: 2.24%. 사람 감독: 3.04%, 네 모델 모두 유의 |
| Finder AI 포트폴리오 대결 | ChatGPT, Gemini, Copilot, DeepSeek, Perplexity, Meta AI, Grok | 모델별 10종목 포트폴리오 4개, 2026년 1~12월(10월까지 결과) | 공격형 포트폴리오는 모두 손실을 내고 두 벤치마크에 모두 뒤처짐. 보수형에서는 DeepSeek가 15.11%로 1위 |
| Dezerv | Grok, ChatGPT, Gemini, Perplexity, Claude | 인도 주식, Nifty 500 TRI 대비, 2025년 8월 4일 시작(6개월 시점) | Gemini와 Perplexity 앞섬, Grok과 ChatGPT 뒤처짐, Claude는 시장과 비슷. 필자는 우연한 변동일 가능성이 높다고 봄 |
| 하버드 비즈니스 스쿨(Wang, Cao, Xiang) | ChatGPT 4.1, DeepSeek R1 | 상하이·선전 4,978개 종목, 2024년 12월 31일 주가 예측 | ChatGPT의 예측 주가가 DeepSeek보다 약 12.5% 높았고, 절대 오차는 13% 컸음 |
Finder는 2026년 10월 업데이트에서 이 테스트가 "비교적 짧은 기간"만 다룬다고 밝혔습니다. Dezerv 글은 모델들을 "규율 있는 포트폴리오 매니저가 아니라 확률적인 브레인스토머"라고 부르며, 실력을 증명하려면 여러 시장 사이클에 걸쳐 일관된 위험조정 수익이 필요하다고 말합니다. 하버드 연구는 포트폴리오가 아니라 예측 테스트지만, 학습 데이터가 모든 답을 한쪽으로 기울일 수 있음을 보여줍니다.
AI의 추천 종목은 왜 물어볼 때마다 바뀌나요?
LLM은 샘플링으로 답을 생성하기 때문에 같은 질문에도 강조점, 종목, 심지어 결론이 달라질 수 있고, 웹 검색 방식도 매번 다릅니다. CNMV 논문의 추론 실패 분류에는 '검색 불안정'(한 질문에서는 수십 개 출처, 비슷한 질문에서는 두 개만 참고)과 '출력 불안정'(0.75로 계산한 점수가 동등한 프롬프트에서 바뀜)이 있고, 오래된 데이터, 지어낸 수치, 통화 혼동, 계산 오류도 포함됩니다. Dezerv 필자도 모델이 비결정적이며 달마다 책임지지 않는다고 지적합니다. 투자자에게 채팅 답변 하나는 가능한 여러 답 가운데 하나의 표본일 뿐이고, 답 자체는 어떤 표본을 뽑았는지 알려주지 않습니다.
저희 데이터에서도 이런 일이 있었습니다. PickSkill의 AI Panel은 DeepSeek V4 Pro, Qwen 3.8 Max, Kimi K3, GLM-5.3, MiniMax M2.5 다섯 모델에게 같은 종목 팩트시트를 읽게 하고, 심판 모델이 의견을 집계합니다. 2026년 11월 19일, 11월 17일 종가(155.46달러) 기준의 같은 데이터로 약 70분 간격을 두고 NVDA를 두 번 분석했습니다. 첫 번째는 중국어로, 두 번째는 영어로 요청했고, 첫 번째에서는 GLM의 의견이 돌아오지 않았기 때문에 엄밀한 통제 실험은 아닙니다. 그래도 결과는 시사하는 바가 큽니다.
- 1회차(UTC 02:21): Qwen과 Kimi 약세, DeepSeek와 MiniMax 중립. 집계 점수 −0.55, 판정은 의견 분열. 심판의 전략: 148.35~155.46 지지 구간에서 소량 시험 매수, 148 이탈 시 손절.
- 2회차(UTC 03:31): GLM, Qwen, MiniMax, DeepSeek 약세, Kimi 중립. 집계 점수 −0.81, 판정은 약세. 심판의 전략: 신규 매수 자제, 162.87 부근 반등 시 비중 축소.
- 바뀐 것: 두 번 모두 답한 네 모델 중 세 모델이 입장을 바꿨습니다. Kimi는 약세에서 중립으로, DeepSeek와 MiniMax는 중립에서 약세로 바뀌었고, Qwen만 그대로였습니다.
- 바뀌지 않은 것: 두 번 모두 중요한 사실, 즉 강한 하락 추세, 과매도 상태의 오실레이터, 148.35 부근 지지에 동의했고 전체적으로 부정적이었습니다.
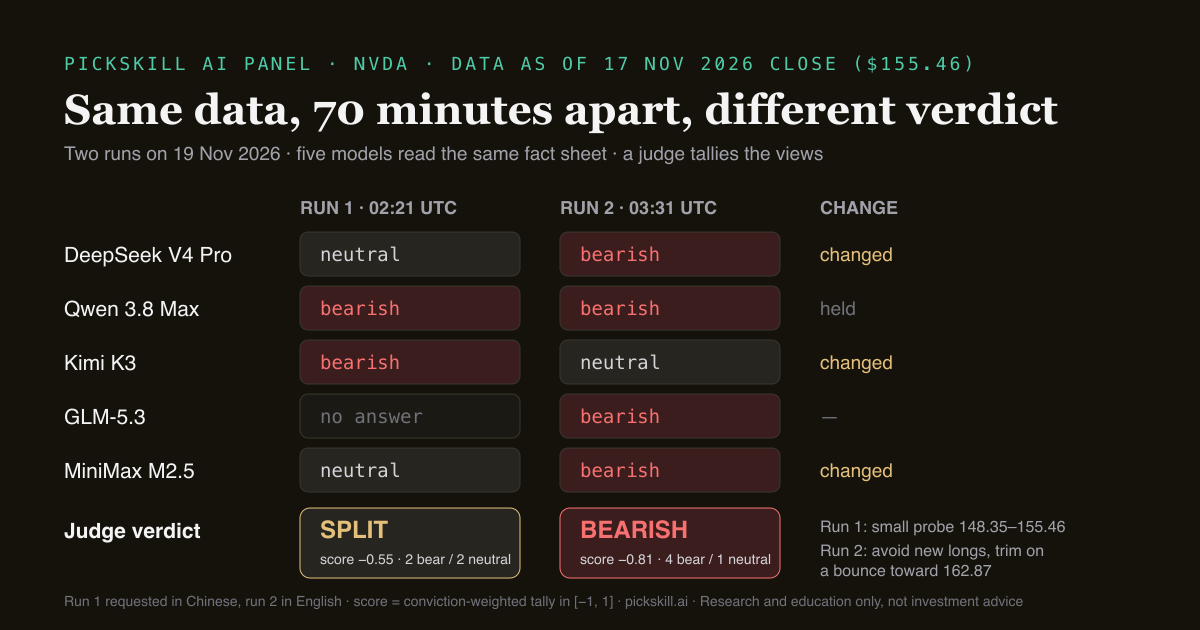
방향은 안정적이었지만 확신과 행동은 그렇지 않았습니다. 둘 중 하나의 답만 봤다면 "반등을 시험 매수"와 "회피" 중 어느 쪽이든 똑같은 확신을 가지고 결론 내렸을 수 있습니다.
AI 모델들은 다 같은 대형주를 고르나요?
자주 그렇고, 이는 확인이 아니라 위험입니다. Hoyoung Lee 등의 LLM 투자 편향 연구(arXiv 2507.20957)는 테스트한 대부분의 모델에서 "기술주, 대형주, 역발상 전략을 선호하는 경향이 관찰된다"고 보고하며, 이런 선호가 확증 편향으로 굳어질 수 있다고 지적합니다. 여러 챗봇이 모두 같은 소수의 초대형주를 추천한다면, 독립적인 결론이 아니라 같은 학습 데이터와 뉴스 보도를 반복하는 것일 수 있습니다. 하버드 연구에서는 중국어 뉴스를 추가하자 ChatGPT의 중국 기업에 대한 낙관이 사라졌습니다. 편향은 모델이 무엇을 읽었는지에서 비롯된 것입니다. Dezerv 필자도 많은 사용자가 같은 AI 추천 종목으로 몰리는 위험을 경고합니다. 모델 간 합의는 모델들이 서로 독립적이고 검증된 같은 사실을 바탕으로 할 때만 의미가 있습니다.
그렇다면 AI를 주식 리서치에 어떻게 써야 하나요?
AI를 종목을 골라주는 기계가 아니라 빠른 리서치 보조이자 세컨드 오피니언으로 대하세요. CNMV 결과가 보여주는 원칙은 간단합니다. 모델에게 구조와 검증된 데이터, 명확한 과제를 주고, 행동하기 전에 추론을 확인하는 것입니다.
- 기억이 아니라 데이터에 근거하게 하세요. 모델이 기억하는 내용이 아니라 날짜가 찍힌 팩트시트(가격 흐름, 시그널, 밸류에이션, 최근 실적)를 바탕으로 판단하게 하세요. CNMV 연구에서는 공식 규제 공시가 예측 정확도를 높였습니다.
- 구조를 요구하세요. "사도 되나요?" 대신 입장, 투자 기간, 근거, 위험, 그리고 생각을 바꿀 조건을 요청하세요. 어떤 정보가 어느 쪽에 속하는지는 기술적 분석과 기본적 분석 비교를 참고하세요.
- 여러 번, 여러 모델에게 물으세요. 같은 질문을 독립적인 여러 모델에 던지고 의견의 분포를 보세요.
- 의견 차이부터 읽으세요. 모델들이 갈리는 곳이 보통 진짜 불확실성이 있는 곳입니다. 지지선, 실적 리스크, 밸류에이션 판단 같은 것들입니다.
- 결정은 자신의 위험 규칙으로 하세요. 어떤 모델도 여러분의 투자 기간, 포지션 크기, 세금 상황을 알지 못합니다.
PickSkill은 1, 3, 4단계를 한 화면에 담았습니다. AI Panel은 다섯 모델에게 같은 팩트시트를 읽게 하고, −1~+1 범위의 확신도 가중 집계 점수와 모델별 입장·근거·위험을 보여줍니다. 심판은 합의점과 이견을 정리하고 강세·약세·중립·의견 분열 네 가지 판정 중 하나를 냅니다. 2026년 11월 17~19일 11회 실행에서 다섯 모델이 만장일치였던 종목은 세 개뿐이었습니다(GOOGL과 META 약세, AAPL 중립). 자유로운 질문에는 시그널과 실적 데이터를 대화로 가져오는 AI 애널리스트 채팅을 쓸 수 있습니다. 전체 도구는 2026 AI 주식 리서치 가이드에서 다룹니다.
AI 종목 선정이 아직 못하는 것은 무엇인가요?
AI는 미래를 볼 수 없고, 데이터가 최신이라고 보장할 수 없으며, 스스로 얼마나 확신해야 하는지도 말하지 못합니다. 공개 테스트는 6~10개월로 짧고, 특정 시장과 몇 달마다 바뀌는 모델 버전을 대상으로 합니다. CNMV 논문은 데이터 검색, 재무 지표 해석, 계산에서 반복적인 오류를 발견했는데, 이런 오류는 단순 질문에 의존하기 쉬운 투자자일수록 잡아내기 어렵습니다. 저희의 AI Panel 11회 실행은 수익률에 대해 말하기엔 너무 적고, 답변이 어떻게 움직이는지만 보여줍니다. AI는 확인을 건너뛰기 위해서가 아니라 확인 범위를 넓히기 위해 쓰세요. 이 글은 리서치와 교육 목적이며 투자 조언이 아닙니다.
FAQ
ChatGPT의 종목 선정은 잘 맞나요? 공개 증거는 엇갈립니다. CNMV 워킹페이퍼 제96호에서 ChatGPT에 단순한 대화식 질문을 했을 때 IBEX 35 종목의 초과수익률은 마이너스였고, 구조화와 사람 감독을 더하자 크게 나아졌습니다. Finder의 2026년 대결에서 공격형 포트폴리오는 2026년 10월 기준 13.09% 하락했습니다. ChatGPT는 혼자 종목을 고르기보다 공시 해설과 리서치 정리에 더 유용합니다.
시장을 이긴 AI가 있나요? 짧은 기간 벤치마크를 이긴 AI 포트폴리오는 있습니다. CNMV 연구에서 네 모델 모두 통계적으로 유의한 초과수익을 냈지만, 구조화 프롬프트와 모든 답에 대한 사람의 검토가 있을 때뿐이었습니다. Finder의 보수형 AI 포트폴리오는 2026년 10월까지 대부분 벤치마크를 이겼지만 공격형은 모두 뒤처졌습니다. 지속적인 실력을 증명할 만큼 긴 테스트는 없습니다.
AI에 물을 때마다 추천 종목이 다른 이유는? LLM은 답을 샘플링으로 생성하고 요청마다 웹 검색 방식도 달라서, 같은 프롬프트에도 다른 종목, 점수, 입장이 나올 수 있습니다. CNMV 논문은 이런 '출력 불안정'을 반복되는 실패로 꼽았습니다. PickSkill AI Panel도 같은 데이터로 약 70분 사이에 NVDA 판정이 '의견 분열'에서 '약세'로 바뀌었습니다.
AI 모델 하나보다 여러 개에 묻는 게 나은가요? 검증된 같은 데이터를 읽은 독립적인 여러 모델에 묻는 것이 답 하나를 믿는 것보다 견고합니다. 어디서 일치하고 어디서 갈리는지 보이기 때문입니다. 다만 대형 기술주 선호처럼 같은 학습 편향을 공유하면 합의는 약한 증거일 뿐이니, 결정 전에 이견과 위험 요인을 읽으세요.
AI가 투자 자문가나 내 리서치를 대신할 수 있나요? 아닙니다. AI는 리서치를 빠르게 하고 공시를 요약하며 세컨드 오피니언을 줄 수 있지만, 여러분의 목표, 투자 기간, 위험 감내도를 모르고 데이터와 계산에서도 실수합니다. 하버드 경영대학원의 Charles Wang 교수는 AI 도구가 "리서치를 가속할 수 있지만 인간의 판단을 대체하지는 못한다"고 말했습니다.