AI 能选股吗?2026 年公开实验怎么说
ChatGPT、Gemini、DeepSeek 等 AI 选股的公开实验结果,为什么同一个模型每次回答都不一样,以及更稳妥的 AI 用法。
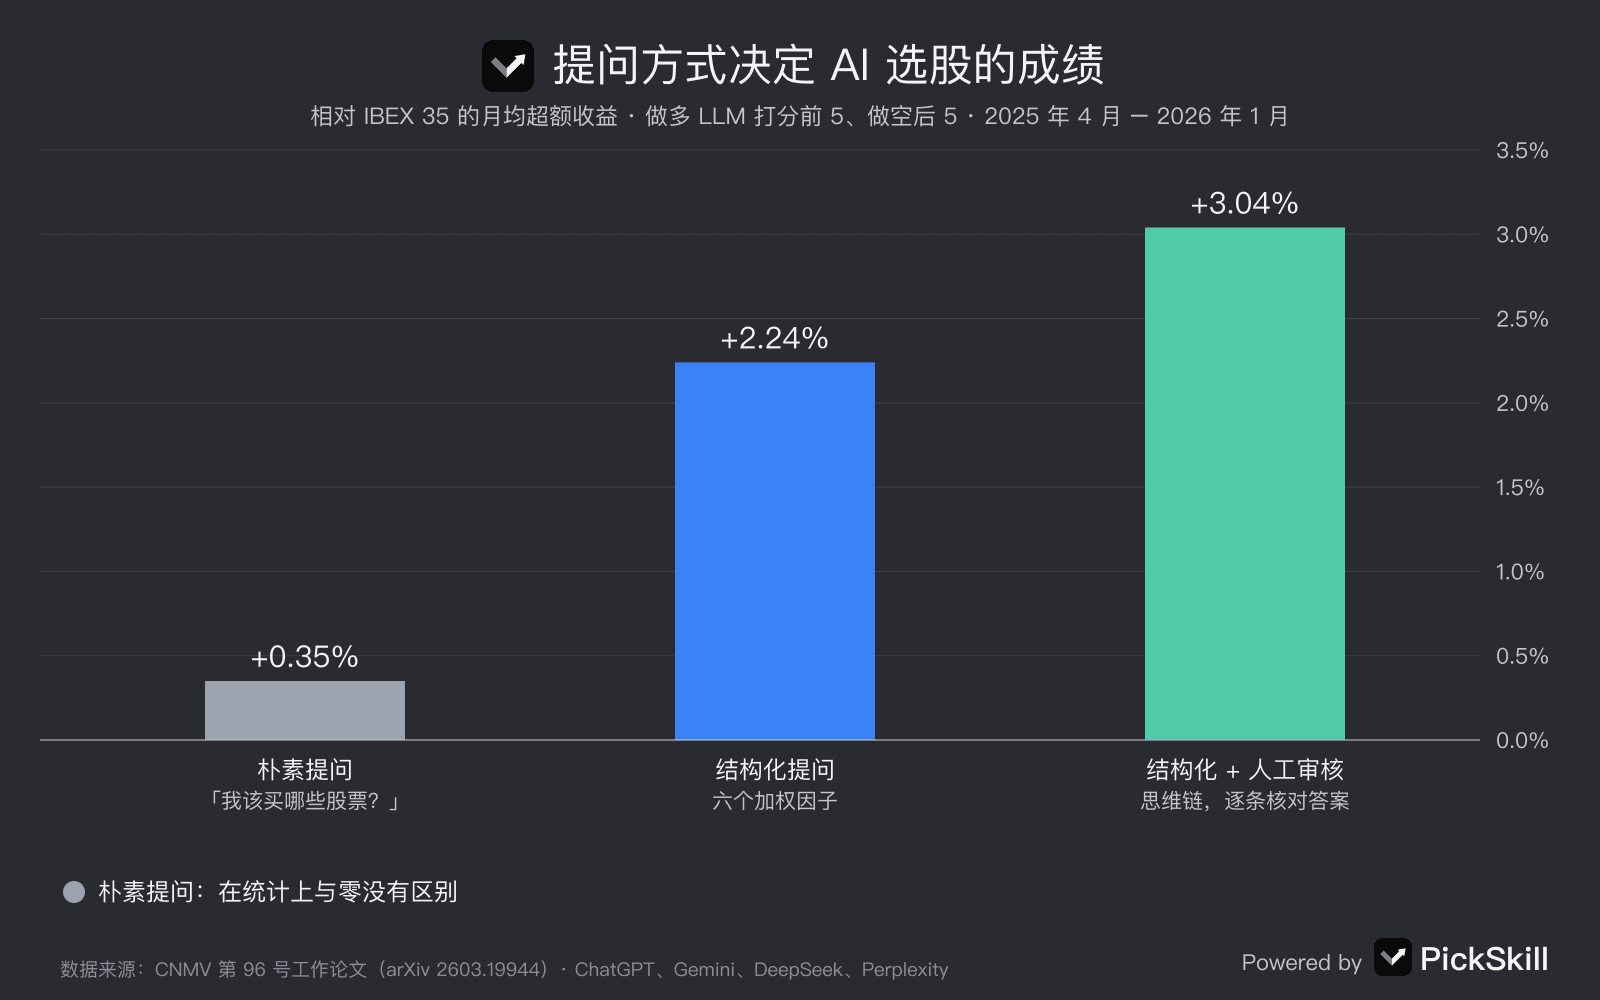
AI 可以帮你研究股票,但目前的公开证据并不能证明聊天机器人能靠自己稳定地选出跑赢市场的股票。AI 选股是指让 ChatGPT、Gemini、DeepSeek 等大语言模型(LLM)挑选或排序它认为能跑赢市场的股票。西班牙证监会(CNMV)2026 年 3 月发布的第 96 号工作论文对 IBEX 35 成分股做了为期十个月的实盘测试:像「我该买哪些股票?」这样的简单提问,月均超额收益只有 0.35%,作者认为在统计上与零没有区别。
一旦提示词变得结构化、并由人来检查模型的推理,结果就明显改善。2025–2026 年的其他公开测试也指向同一结论:结果好坏参半,很大程度上取决于你怎么问,而单个模型的一次回答还不够稳定,不能当作「神谕」。
核心要点
- 证据好坏参半。 下文四项公开实验中,有的 AI 组合跑赢基准,有的落后,而且测试期往往只有六到十个月。
- 怎么问和问哪个模型一样重要。 CNMV 研究中,月均超额收益从 0.35%(朴素提问)升至 2.24%(结构化提问),再到 3.04%(结构化提问加人工审核)。
- 单个模型、单次回答噪声很大。 CNMV 作者把「输出不稳定」(相同提示词得到不同输出)列为反复出现的问题;我们自己的 AI Panel 在相同数据上、相隔约 70 分钟,先给 NVDA「分歧」结论,后给「看空」结论。
- 模型有共同盲点。 研究发现模型普遍偏好科技股和大盘股;哈佛商学院的研究则发现,由于缺少中国负面新闻,ChatGPT 对 A 股的预测比 DeepSeek 更乐观。
- 把 AI 用于研究和第二意见, 对比多个相互独立的模型,并重点看它们的分歧。
AI 真的能选出跑赢大盘的股票吗?
就目前已发表的研究看,单靠 AI 并不可靠。最严谨的公开测试是 CNMV 第 96 号工作论文《Large Language Models and Stock Investing: Is the Human Factor Required?》,作者是西班牙证监会的 Ricardo Crisóstomo 和 Diana Mykhalyuk。2025 年 4 月至 2026 年 1 月,他们在每月第一个交易日让 ChatGPT、Gemini、DeepSeek 和 Perplexity 为 IBEX 35 全部 35 只成分股打分,再构建「做多得分最高 5 只、做空得分最低 5 只」的多空组合进行检验。朴素提问的月均超额收益为 0.35%,统计上与零无异;加入六个加权因子的结构化提问提升到 2.24%;在此基础上逐条人工审核的思维链(chain-of-thought)提问达到 3.04%。作者的结论是:在引导和监督下,LLM「能够跑赢市场」,但这种超额收益在自主运行时「既不是自动的,也不稳健」。
公开的 AI 选股实验发现了什么?
2025–2026 年的四项公开测试覆盖了不同市场、模型和设置,没有一项的时间长到足以下定论。放在一起看,结果随模型、风险等级和时间窗口大幅波动,而较好的结果往往伴随着更多结构或人工监督。
| 谁做的 | 模型 | 市场与时间 | 发现 |
|---|---|---|---|
| CNMV 第 96 号工作论文 | ChatGPT、Gemini、DeepSeek、Perplexity | IBEX 35,2025 年 4 月 – 2026 年 1 月,按月 | 朴素提问:月均超额 0.35%(不显著);结构化:2.24%;人工监督:3.04%,四个模型均显著 |
| Finder AI 组合大比拼 | ChatGPT、Gemini、Copilot、DeepSeek、Perplexity、Meta AI、Grok | 每个模型 4 个 10 只股票的组合,2026 年 1–12 月(数据截至 10 月) | 所有激进型组合均亏损且落后于两个基准;保守型组合中 DeepSeek 以 15.11% 领先 |
| Dezerv | Grok、ChatGPT、Gemini、Perplexity、Claude | 印度股票,对比 Nifty 500 TRI,自 2025 年 8 月 4 日起(六个月检查点) | Gemini 和 Perplexity 领先,Grok 和 ChatGPT 落后,Claude 与市场大致持平;作者认为结果很可能只是随机波动 |
| 哈佛商学院(Wang、Cao、Xiang) | ChatGPT 4.1、DeepSeek R1 | 4,978 只沪深 A 股,预测 2024 年 12 月 31 日股价 | ChatGPT 的预测价格比 DeepSeek 高约 12.5%,绝对误差大 13% |
Finder 在 2026 年 10 月的更新中提醒,这项测试只覆盖「相对较短的时间」。Dezerv 的文章把这些模型称为「随机的头脑风暴者,而不是有纪律的基金经理」,并指出要证明能力,需要在不同市场周期中取得一致的风险调整后收益。哈佛的研究是预测测试而不是投资组合,但它说明训练数据会让每一个回答都偏向同一个方向。
为什么 AI 每次给的选股结果都不一样?
大语言模型通过采样生成回答,所以同一个问题可能得到不同的侧重点、不同的股票,甚至不同的结论;它们每次联网搜索的方式也不同。CNMV 论文总结的推理失误分类中,既有「搜索不稳定」(一次查询参考几十个来源,类似的查询只参考两个),也有「输出不稳定」(算出 0.75 分,换个等价提问就变了),此外还有使用过时数据、编造数字、混用货币和算术错误。Dezerv 的作者也指出,这些模型是非确定性的,月与月之间没有任何问责。对投资者来说,一次聊天回答只是众多可能回答中的一个样本,而回答本身并不会告诉你抽到的是哪一个。
我们在自己的数据里也看到了这一点。PickSkill 的 AI Panel 让 DeepSeek V4 Pro、Qwen 3.8 Max、Kimi K3、GLM-5.3 和 MiniMax M2.5 五个模型读取同一份股票事实数据,再由裁判模型汇总观点。2026 年 11 月 19 日,我们对 NVDA 连续跑了两次,相隔约 70 分钟,用的是同一份截至 11 月 17 日收盘(155.46 美元)的数据。第一次用中文发起、第二次用英文发起,而且第一次 GLM 的观点没有返回,所以这不是一次严格对照的测试。但结果依然很说明问题:
- 第 1 次(UTC 02:21): Qwen 和 Kimi 看空,DeepSeek 和 MiniMax 中性。汇总得分 −0.55,结论为分歧。裁判给出的策略:在 148.35–155.46 支撑区轻仓试探,跌破 148 止损。
- 第 2 次(UTC 03:31): GLM、Qwen、MiniMax 和 DeepSeek 看空,Kimi 中性。汇总得分 −0.81,结论为看空。裁判给出的策略:不开新多仓,反弹至 162.87 附近时减仓。
- 变了什么: 两次都给出观点的四个模型中,有三个改变了立场。Kimi 从看空转为中性,DeepSeek 和 MiniMax 从中性转为看空,只有 Qwen 保持不变。
- 没变什么: 两次都认同关键事实——下跌趋势强劲、震荡指标超卖、148.35 附近有支撑——并且整体都偏负面。
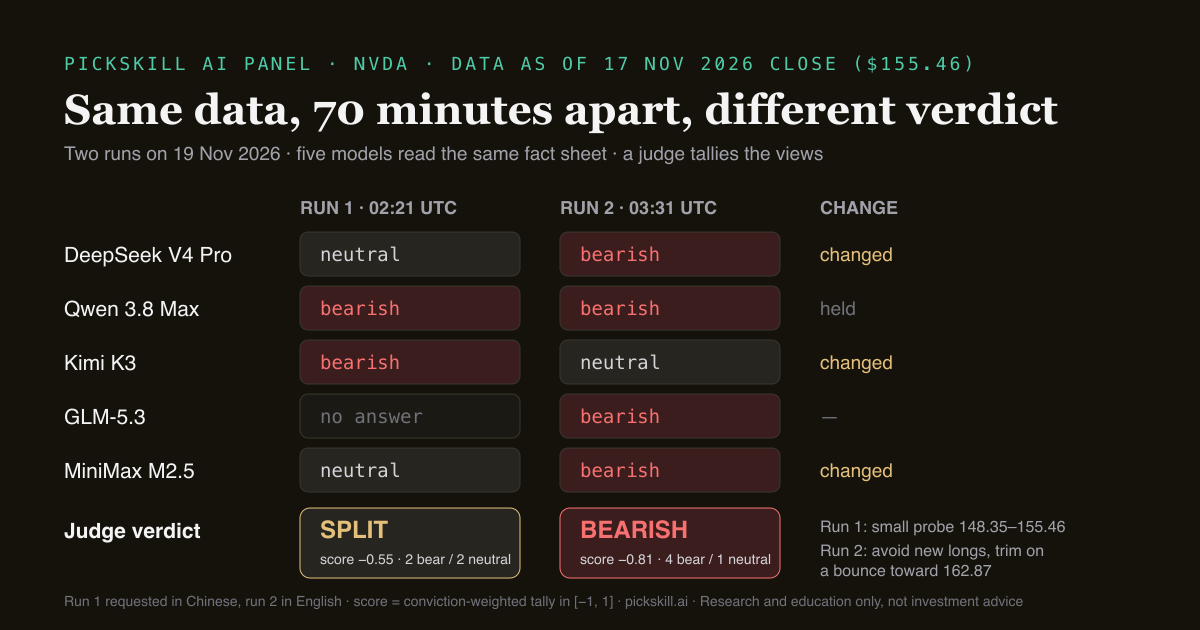
方向是稳定的,信心和操作建议却不是。如果你只看到其中一次回答,你可能同样笃定地得出「轻仓抄反弹」或「回避」两种截然不同的结论。
不同的 AI 模型是不是都选同几只大盘股?
经常是,而这更像是风险而不是相互印证。Hoyoung Lee 等人关于 LLM 投资偏差的研究(arXiv 2507.20957)指出,在大多数受测模型中「可以观察到偏好科技股、大盘股和逆向策略的倾向」,而且这些偏好可能固化为确认偏误。当几个聊天机器人都推荐同一批超大盘股时,它们可能只是在重复相同的训练数据和新闻报道,而不是各自独立得出结论。在哈佛的研究中,研究者给 ChatGPT 补充中文新闻后,它对中国公司的过度乐观就消失了,说明偏差来自模型读过什么。Dezerv 的作者也提醒,大量用户可能会集中买入同样的 AI 推荐股。只有当模型彼此独立、且基于同一份经过核实的事实时,它们之间的一致才有意义。
那应该怎样用 AI 做股票研究?
把 AI 当作高效的研究助手和第二意见,而不是选股机器。CNMV 的结果给出一个简单原则:给模型结构、经过核实的数据和清晰的任务,并在行动前检查它的推理。
- 让它基于数据,而不是记忆。 让模型基于一份标明日期的事实数据工作——价格走势、技术信号、估值、最新财报——而不是凭它记住的内容。CNMV 研究发现,官方监管披露能提高预测准确度。
- 要求结构化输出。 不要问「这只股票能买吗?」,而是要求它给出立场、时间周期、理由、风险,以及什么情况会让它改变看法。参见技术分析与基本面分析,了解哪些输入属于哪一边。
- 多问几次,多问几个模型。 把同一个问题交给多个独立模型,看看观点的分布。
- 先看分歧。 模型之间的分歧往往正是真正不确定的地方:一个支撑位、一项财报风险、一个估值判断。
- 按你自己的风险规则做决定。 没有任何模型知道你的投资周期、仓位大小或税务情况。
PickSkill 把第 1、3、4 步放进了同一个页面。AI Panel 让五个模型读取同一份事实数据,显示 −1 到 +1 之间按信心加权的汇总得分,以及每个模型的立场、理由和风险;裁判模型列出一致点和分歧点,并给出看多、看空、中性或分歧四种结论之一。在 2026 年 11 月 17–19 日的 11 次运行中,五个模型只在三只股票上意见完全一致(GOOGL 和 META 看空,AAPL 中性)。开放式问题可以用 AI 分析师对话,把技术信号和财报数据带入对话。更多工具可参考我们的 2026 年 AI 股票研究指南。
AI 选股目前还做不到什么?
AI 看不到未来,不能保证数据是最新的,也说不清自己应该有多大把握。现有公开测试都很短,只有六到十个月,针对特定市场和每隔几个月就更新的模型版本。CNMV 论文发现,模型在数据检索、财务解读和算术上反复出错,而最依赖简单提问的投资者恰恰最难发现这些错误。我们的 11 次 AI Panel 运行样本太小,无法说明任何收益问题,只能展示回答的行为方式。用 AI 扩大你检查的范围,而不是跳过检查。本文仅供研究和学习,不构成投资建议。
FAQ
ChatGPT 选股准吗? 公开证据好坏参半。在 CNMV 第 96 号工作论文中,ChatGPT 用简单对话式提问选 IBEX 35 股票,超额收益为负;结构化提问和人工监督下则好得多。在 Finder 2026 年的比拼中,截至 2026 年 10 月,它的激进型组合下跌 13.09%。ChatGPT 更适合解读财报、整理研究框架,而不是独立选股。
有 AI 跑赢过股市吗? 有些 AI 组合在短期内跑赢了基准。CNMV 研究中四个模型都取得了统计显著的超额收益,但前提是结构化提问加上对每个回答的人工审核。截至 2026 年 10 月,Finder 的保守型 AI 组合大多跑赢基准,而激进型组合全部落后。这些测试都不够长,无法证明持续的能力。
为什么每次问 AI,推荐的股票都不一样? 大语言模型通过采样生成回答,每次联网搜索的方式也不同,所以相同的提示词可能返回不同的股票、评分或立场。CNMV 论文把这种「输出不稳定」列为反复出现的问题。PickSkill 的 AI Panel 在同一份数据上、相隔约 70 分钟,把 NVDA 的结论从「分歧」变成了「看空」。
问多个 AI 模型比只问一个更好吗? 让多个相互独立的模型读取同一份经过核实的数据,比只相信一个回答更稳妥,因为你能看到它们在哪里一致、在哪里分歧。但如果模型共享同样的训练偏差,比如都偏好大盘科技股,那么一致本身只是弱证据,所以决定之前要先读分歧和风险提示。
AI 能取代投资顾问或我自己的研究吗? 不能。AI 可以加快研究、总结财报、提供第二意见,但它不了解你的目标、投资周期和风险承受能力,而且会在数据和算术上出错。哈佛商学院教授 Charles Wang 说得很直接:AI 工具「可以加速研究,但不能替代人的判断」。