AI 能選股嗎?2026 年公開實驗怎麼說
ChatGPT、Gemini、DeepSeek 等 AI 選股的公開實驗結果,為什麼同一個模型每次回答都不一樣,以及更穩妥的 AI 用法。
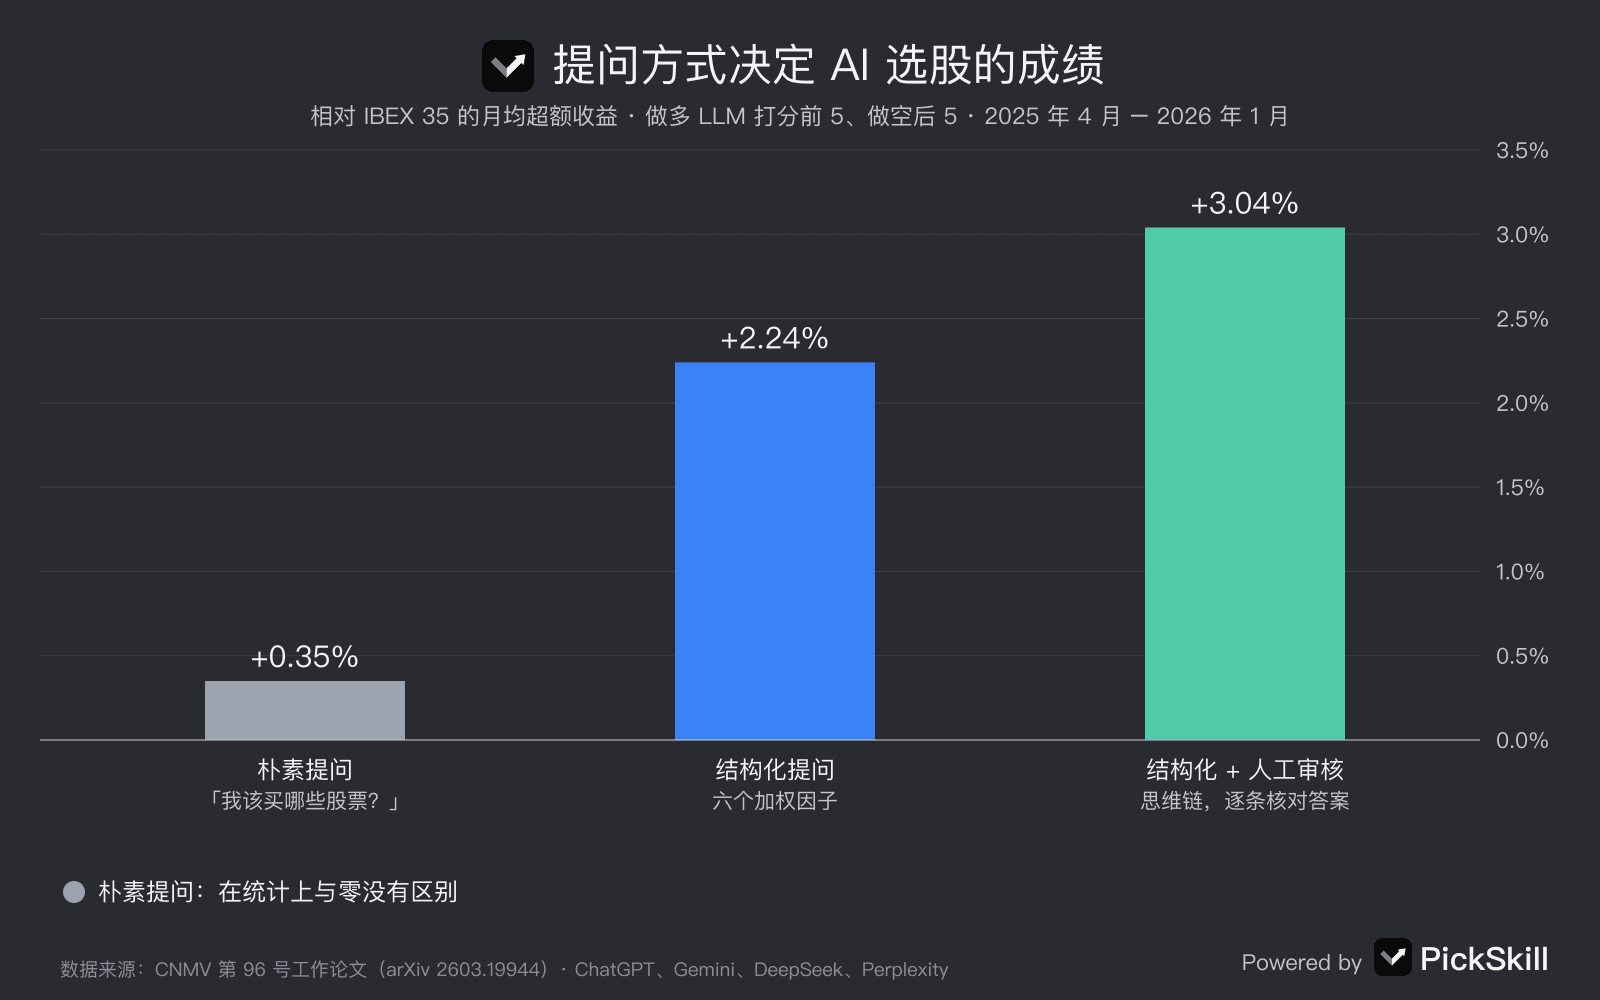
AI 可以幫你研究股票,但目前的公開證據並不能證明聊天機器人能靠自己穩定地選出跑贏市場的股票。AI 選股是指讓 ChatGPT、Gemini、DeepSeek 等大語言模型(LLM)挑選或排序它認為能跑贏市場的股票。西班牙證券市場委員會(CNMV)2026 年 3 月釋出的第 96 號工作論文對 IBEX 35 成分股做了為期十個月的實盤測試:像「我該買哪些股票?」這樣的簡單提問,月均超額報酬只有 0.35%,作者認為在統計上與零沒有區別。
一旦提示詞變得結構化、並由人來檢查模型的推理,結果就明顯改善。2025–2026 年的其他公開測試也指向同一結論:結果好壞參半,很大程度上取決於你怎麼問,而單個模型的一次回答還不夠穩定,不能當作「神諭」。
核心要點
- 證據好壞參半。 下文四項公開實驗中,有的 AI 組合跑贏基準,有的落後,而且測試期往往只有六到十個月。
- 怎麼問和問哪個模型一樣重要。 CNMV 研究中,月均超額報酬從 0.35%(簡單提問)升至 2.24%(結構化提問),再到 3.04%(結構化提問加人工審核)。
- 單個模型、單次回答噪聲很大。 CNMV 作者把「輸出不穩定」(相同提示詞得到不同輸出)列為反覆出現的問題;我們自己的 AI Panel 在相同資料上、相隔約 70 分鐘,先給 NVDA「分歧」結論,後給「看空」結論。
- 模型有共同盲點。 研究發現模型普遍偏好科技股和大型股;哈佛商學院的研究則發現,由於缺少中國負面新聞,ChatGPT 對 A 股的預測比 DeepSeek 更樂觀。
- 把 AI 用於研究和第二意見, 對比多個相互獨立的模型,並重點看它們的分歧。
AI 真的能選出跑贏大盤的股票嗎?
就目前已發表的研究看,單靠 AI 並不可靠。最嚴謹的公開測試是 CNMV 第 96 號工作論文《Large Language Models and Stock Investing: Is the Human Factor Required?》,作者是西班牙證券市場委員會的 Ricardo Crisóstomo 和 Diana Mykhalyuk。2025 年 4 月至 2026 年 1 月,他們在每月第一個交易日讓 ChatGPT、Gemini、DeepSeek 和 Perplexity 為 IBEX 35 全部 35 只成分股打分,再構建「做多得分最高 5 只、做空得分最低 5 只」的多空組合進行檢驗。簡單提問的月均超額報酬為 0.35%,統計上與零無異;加入六個加權因子的結構化提問提升到 2.24%;在此基礎上逐條人工審核的思維鏈(chain-of-thought)提問達到 3.04%。作者的結論是:在引導和監督下,LLM「能夠跑贏市場」,但這種超額報酬在自主執行時「既不是自動的,也不穩健」。
公開的 AI 選股實驗發現了什麼?
2025–2026 年的四項公開測試覆蓋了不同市場、模型和設定,沒有一項的時間長到足以下定論。放在一起看,結果隨模型、風險等級和時間視窗大幅波動,而較好的結果往往伴隨著更多結構或人工監督。
| 誰做的 | 模型 | 市場與時間 | 發現 |
|---|---|---|---|
| CNMV 第 96 號工作論文 | ChatGPT、Gemini、DeepSeek、Perplexity | IBEX 35,2025 年 4 月 – 2026 年 1 月,按月 | 簡單提問:月均超額 0.35%(不顯著);結構化:2.24%;人工監督:3.04%,四個模型均顯著 |
| Finder AI 組合大比拼 | ChatGPT、Gemini、Copilot、DeepSeek、Perplexity、Meta AI、Grok | 每個模型 4 個 10 只股票的組合,2026 年 1–12 月(資料截至 10 月) | 所有激進型組合均虧損且落後於兩個基準;保守型組合中 DeepSeek 以 15.11% 領先 |
| Dezerv | Grok、ChatGPT、Gemini、Perplexity、Claude | 印度股票,對比 Nifty 500 TRI,自 2025 年 8 月 4 日起(六個月檢查點) | Gemini 和 Perplexity 領先,Grok 和 ChatGPT 落後,Claude 與市場大致持平;作者認為結果很可能只是隨機波動 |
| 哈佛商學院(Wang、Cao、Xiang) | ChatGPT 4.1、DeepSeek R1 | 4,978 只滬深 A 股,預測 2024 年 12 月 31 日股價 | ChatGPT 的預測價格比 DeepSeek 高約 12.5%,絕對誤差大 13% |
Finder 在 2026 年 10 月的更新中提醒,這項測試只覆蓋「相對較短的時間」。Dezerv 的文章把這些模型稱為「隨機的頭腦風暴者,而不是有紀律的基金經理」,並指出要證明能力,需要在不同市場週期中取得一致的風險調整後報酬。哈佛的研究是預測測試而不是投資組合,但它說明訓練資料會讓每一個回答都偏向同一個方向。
為什麼 AI 每次給的選股結果都不一樣?
大語言模型透過取樣生成回答,所以同一個問題可能得到不同的側重點、不同的股票,甚至不同的結論;它們每次聯網搜尋的方式也不同。CNMV 論文總結的推理失誤分類中,既有「搜尋不穩定」(一次查詢參考幾十個來源,類似的查詢只參考兩個),也有「輸出不穩定」(算出 0.75 分,換個等價提問就變了),此外還有使用過時資料、編造數字、混用貨幣和計算錯誤。Dezerv 的作者也指出,這些模型是非確定性的,月與月之間沒有任何問責。對投資者來說,一次聊天回答只是眾多可能回答中的一個樣本,而回答本身並不會告訴你抽到的是哪一個。
我們在自己的資料裡也看到了這一點。PickSkill 的 AI Panel 讓 DeepSeek V4 Pro、Qwen 3.8 Max、Kimi K3、GLM-5.3 和 MiniMax M2.5 五個模型讀取同一份股票事實資料,再由裁判模型彙總觀點。2026 年 11 月 19 日,我們對 NVDA 連續跑了兩次,相隔約 70 分鐘,用的是同一份截至 11 月 17 日收盤(155.46 美元)的資料。第一次用中文發起、第二次用英文發起,而且第一次 GLM 的觀點沒有回傳,所以這不是一次嚴格對照的測試。但結果依然很說明問題:
- 第 1 次(UTC 02:21): Qwen 和 Kimi 看空,DeepSeek 和 MiniMax 中性。彙總得分 −0.55,結論為分歧。裁判給出的策略:在 148.35–155.46 支撐區輕倉試探,跌破 148 止損。
- 第 2 次(UTC 03:31): GLM、Qwen、MiniMax 和 DeepSeek 看空,Kimi 中性。彙總得分 −0.81,結論為看空。裁判給出的策略:不開新多倉,反彈至 162.87 附近時減倉。
- 變了什麼: 兩次都給出觀點的四個模型中,有三個改變了立場。Kimi 從看空轉為中性,DeepSeek 和 MiniMax 從中性轉為看空,只有 Qwen 保持不變。
- 沒變什麼: 兩次都認同關鍵事實——下跌趨勢強勁、震盪指標超賣、148.35 附近有支撐——並且整體都偏負面。
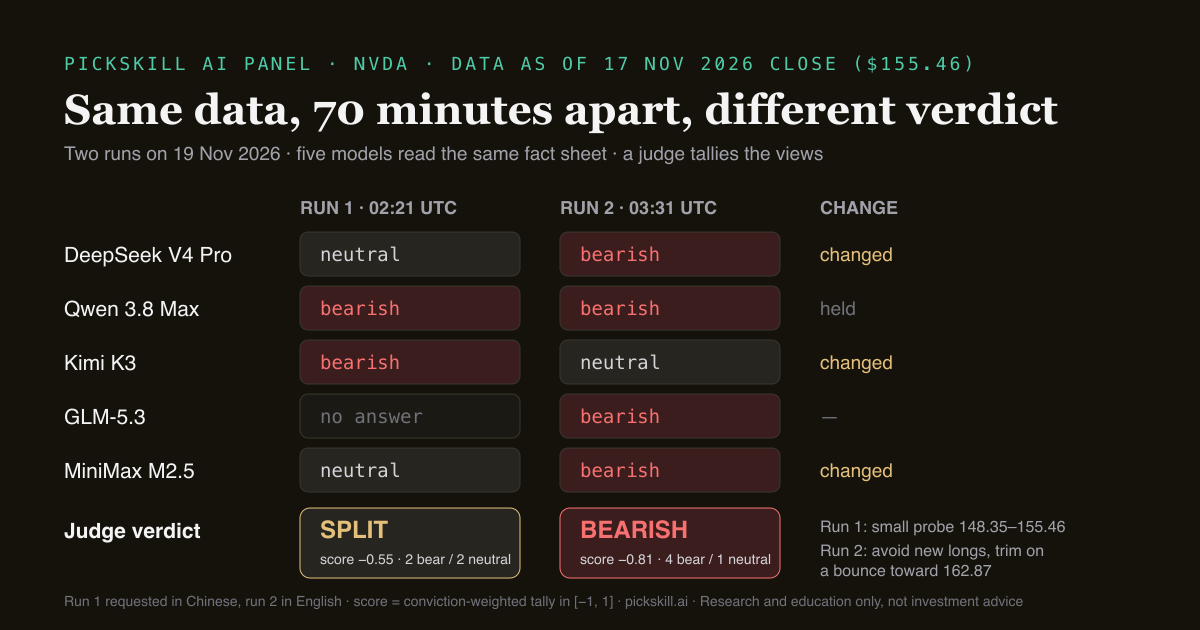
方向是穩定的,信心和操作建議卻不是。如果你只看到其中一次回答,你可能同樣篤定地得出「輕倉抄反彈」或「迴避」兩種截然不同的結論。
不同的 AI 模型是不是都選同幾隻大型股?
經常是,而這更像是風險而不是相互印證。Hoyoung Lee 等人關於 LLM 投資偏差的研究(arXiv 2507.20957)指出,在大多數受測模型中「可以觀察到偏好科技股、大型股和逆向策略的傾向」,而且這些偏好可能固化為確認偏誤。當幾個聊天機器人都推薦同一批超大型股時,它們可能只是在重複相同的訓練資料和新聞報道,而不是各自獨立得出結論。在哈佛的研究中,研究者給 ChatGPT 補充中文新聞後,它對中國公司的過度樂觀就消失了,說明偏差來自模型讀過什麼。Dezerv 的作者也提醒,大量使用者可能會集中買入同樣的 AI 推薦股。只有當模型彼此獨立、且基於同一份經過核實的事實時,它們之間的一致才有意義。
那應該怎樣用 AI 做股票研究?
把 AI 當作高效的研究助手和第二意見,而不是選股機器。CNMV 的結果給出一個簡單原則:給模型結構、經過核實的資料和清晰的任務,並在行動前檢查它的推理。
- 讓它基於資料,而不是記憶。 讓模型基於一份標明日期的事實資料工作——價格走勢、技術訊號、估值、最新財報——而不是憑它記住的內容。CNMV 研究發現,官方監管披露能提高預測準確度。
- 要求結構化輸出。 不要問「這隻股票能買嗎?」,而是要求它給出立場、時間週期、理由、風險,以及什麼情況會讓它改變看法。參見技術分析與基本面分析,瞭解哪些輸入屬於哪一邊。
- 多問幾次,多問幾個模型。 把同一個問題交給多個獨立模型,看看觀點的分佈。
- 先看分歧。 模型之間的分歧往往正是真正不確定的地方:一個支撐位、一項財報風險、一個估值判斷。
- 按你自己的風險規則做決定。 沒有任何模型知道你的投資期間、倉位大小或稅務情況。
PickSkill 把第 1、3、4 步放進了同一個頁面。AI Panel 讓五個模型讀取同一份事實資料,顯示 −1 到 +1 之間按信心加權的彙總得分,以及每個模型的立場、理由和風險;裁判模型列出一致點和分歧點,並給出看多、看空、中性或分歧四種結論之一。在 2026 年 11 月 17–19 日的 11 次執行中,五個模型只在三隻股票上意見完全一致(GOOGL 和 META 看空,AAPL 中性)。開放式問題可以用 AI 分析師對話,把技術訊號和財報資料帶入對話。更多工具可參考我們的 2026 年 AI 股票研究指南。
AI 選股目前還做不到什麼?
AI 看不到未來,不能保證資料是最新的,也說不清自己應該有多大把握。現有公開測試都很短,只有六到十個月,針對特定市場和每隔幾個月就更新的模型版本。CNMV 論文發現,模型在資料檢索、財務解讀和計算上反覆出錯,而最依賴簡單提問的投資者恰恰最難發現這些錯誤。我們的 11 次 AI Panel 執行樣本太小,無法說明任何報酬問題,只能展示回答的行為方式。用 AI 擴大你檢查的範圍,而不是跳過檢查。本文僅供研究和學習,不構成投資建議。
FAQ
ChatGPT 選股準嗎? 公開證據好壞參半。在 CNMV 第 96 號工作論文中,ChatGPT 用簡單對話式提問選 IBEX 35 股票,超額報酬為負;結構化提問和人工監督下則好得多。在 Finder 2026 年的比拼中,截至 2026 年 10 月,它的激進型組合下跌 13.09%。ChatGPT 更適合解讀財報、整理研究框架,而不是獨立選股。
有 AI 跑贏過股市嗎? 有些 AI 組合在短期內跑贏了基準。CNMV 研究中四個模型都取得了統計顯著的超額報酬,但前提是結構化提問加上對每個回答的人工審核。截至 2026 年 10 月,Finder 的保守型 AI 組合大多跑贏基準,而激進型組合全部落後。這些測試都不夠長,無法證明持續的能力。
為什麼每次問 AI,推薦的股票都不一樣? 大語言模型透過取樣生成回答,每次聯網搜尋的方式也不同,所以相同的提示詞可能返回不同的股票、評分或立場。CNMV 論文把這種「輸出不穩定」列為反覆出現的問題。PickSkill 的 AI Panel 在同一份資料上、相隔約 70 分鐘,把 NVDA 的結論從「分歧」變成了「看空」。
問多個 AI 模型比只問一個更好嗎? 讓多個相互獨立的模型讀取同一份經過核實的資料,比只相信一個回答更穩妥,因為你能看到它們在哪裡一致、在哪裡分歧。但如果模型共享同樣的訓練偏差,比如都偏好大盤科技股,那麼一致本身只是弱證據,所以決定之前要先讀分歧和風險提示。
AI 能取代投資顧問或我自己的研究嗎? 不能。AI 可以加快研究、總結財報、提供第二意見,但它不瞭解你的目標、投資期間和風險承受能力,而且會在資料和計算上出錯。哈佛商學院教授 Charles Wang 說得很直接:AI 工具「可以加速研究,但不能替代人的判斷」。