DeepSeek、Qwen、Kimi 谁更会分析股票?
DeepSeek、Qwen、Kimi、GLM、MiniMax 读同一份数据分析 11 只股票:看多看空、信心分、唱反调次数有何不同,附统计方法。
就目前的数据而言,还谈不上哪个 AI 模型分析股票“最好”,但它们的行为差异很明显:读同一份数据时,DeepSeek V4 Pro 最果断,Qwen 3.8 Max 最谨慎,Kimi K3 最常和大家唱反调。 DeepSeek、Qwen、Kimi 的对比,是在检验每个大语言模型(LLM)如何把完全相同的行情数据变成观点、信心分和操作计划。在 2026 年 11 月 17–19 日数据上的 11 次 PickSkill 多模型会诊中,DeepSeek 平均信心分 3.36(满分 5),且一次都没看多;Qwen 平均 2.60,从没超过 3。
这是行为对比,不是准确率排名。这些分析才过去几天,还没有结果可供打分;11 次运行(53 条模型观点)也只是很小的样本。数据能告诉我们的,是在其他条件完全一致时,模型之间有什么不同。
要点速览
- 同样的输入,不同的性格。 每次运行五个模型读的是同一份数据。DeepSeek V4 Pro 在 11 次中 7 次看空、0 次看多;MiniMax M2.5 有 6 次保持中性。
- 信心分差距不大,但真实存在。 DeepSeek 在 11 条观点里有 5 条给了 4 分;Qwen 每次都只给 2 或 3 分。没有模型用过 1 分或 5 分。
- Kimi K3 最爱唱反调。 它两次成为唯一的异见者,也是唯一看多 600674.SS 的模型。DeepSeek 同样两次独自持不同意见。
- 稳定性和速度各不相同。 Qwen 有一次没交卷(触发 170 秒超时),中位响应时间最慢,为 107 秒;MiniMax 中位只要 10 秒。
- 同一只股票跑两次,结论会变。 NVDA 在完全相同的数据上跑了两次;两次都作答的四个模型里,三个改变了立场。
- 不是准确率排名。 样本只有 11 次,尚无结果。请把它理解为“各模型的行为方式”,而非“哪个模型说得对”。
我们到底比较了什么?
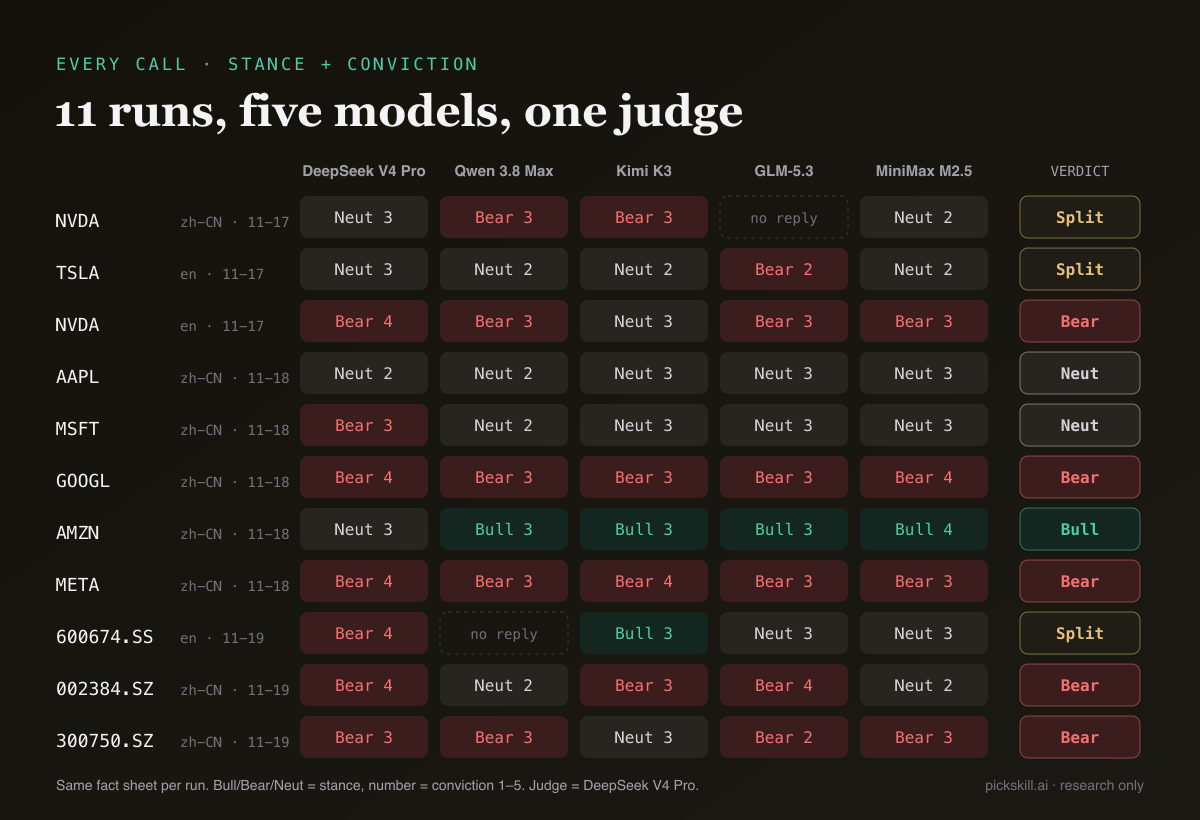
我们比较的是 PickSkill 多模型会诊上的五个 LLM:DeepSeek V4 Pro、Qwen 3.8 Max、Kimi K3、GLM-5.3 和 MiniMax M2.5。每次运行时,所有模型拿到同一只股票的同一份 JSON 数据表:近期价格走势、八个技术指标(MACD、均线、RSI、KDJ、布林带、ADX、成交量、资金流向)及各自的 5 日信号轨迹、估值指标和最新财报。每个模型给出立场(看多、看空或中性)、1–5 分的信心分、持有周期、理由、风险和只做多的操作策略。随后由 DeepSeek V4 Pro 担任裁判,读完所有观点后给出结论(看多、看空、中性或分歧)。样本是 2026 年 11 月 17–19 日保存的全部运行:NVDA 两次,TSLA、AAPL、MSFT、GOOGL、AMZN、META,以及三只 A 股(600674.SS、002384.SZ、300750.SZ)。理论上应有 55 条观点,实际收到 53 条。
为什么相同的输入才能公平比较?
只有输入完全相同,输出的差异才能归因于模型本身。如果你分别在 DeepSeek、通义千问和 Kimi 自己的 App 里问同一只股票,它们联网搜索的方式不同,看到的可能是不同日期的价格,系统提示词不同,读到的新闻也不同。这时出现分歧说明不了什么:可能是数据不同,而不是推理不同。在多模型会诊里,同一次运行里每个模型拿到同一份数据表、同样的指令(“只用提供的数据,绝不编造数字”)和同样的输出格式,五个模型还是同一时刻并行调用。此后立场、信心分、所选价位上的差异,都来自模型本身。这种测试公平,但范围有限:考的是对结构化数据的推理,而不是读新闻或做估值。
DeepSeek、Qwen、Kimi 有什么不同?
DeepSeek V4 Pro 最果断也最偏空,Qwen 3.8 Max 最克制,Kimi K3 最独立。DeepSeek 一次都没看多,11 条观点是 7 条看空、4 条中性,平均信心分 3.36,五个模型中最高。Qwen 有 4 次给 2 分、6 次给 3 分,从未更高,平均 2.60 为最低。Kimi 看多次数最多(2 次),11 次中有 9 次信心分为 3,还两次成为唯一异见者:英文版 NVDA 和 300750.SZ 上,其余四个模型都看空,只有它给了中性。
| 模型 | 作答 | 看多 / 中性 / 看空 | 平均信心分 | 与裁判一致* | 唯一异见 | 中位响应 |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 11 / 11 | 0 / 4 / 7 | 3.36 | 6 / 8 | 2 | 56 秒 |
| Qwen 3.8 Max | 10 / 11 | 1 / 4 / 5 | 2.60 | 7 / 8 | 0 | 107 秒 |
| Kimi K3 | 11 / 11 | 2 / 5 / 4 | 3.00 | 6 / 8 | 2 | 50 秒 |
| GLM-5.3 | 10 / 11 | 1 / 3 / 6 | 2.90 | 8 / 8 | 1 | 58 秒 |
| MiniMax M2.5 | 11 / 11 | 1 / 6 / 4 | 2.91 | 7 / 8 | 0 | 10 秒 |
*只统计裁判给出明确方向的 8 次运行;另外 3 次为“分歧”。数据:PickSkill 多模型会诊,基于 2026 年 11 月 17–19 日数据。
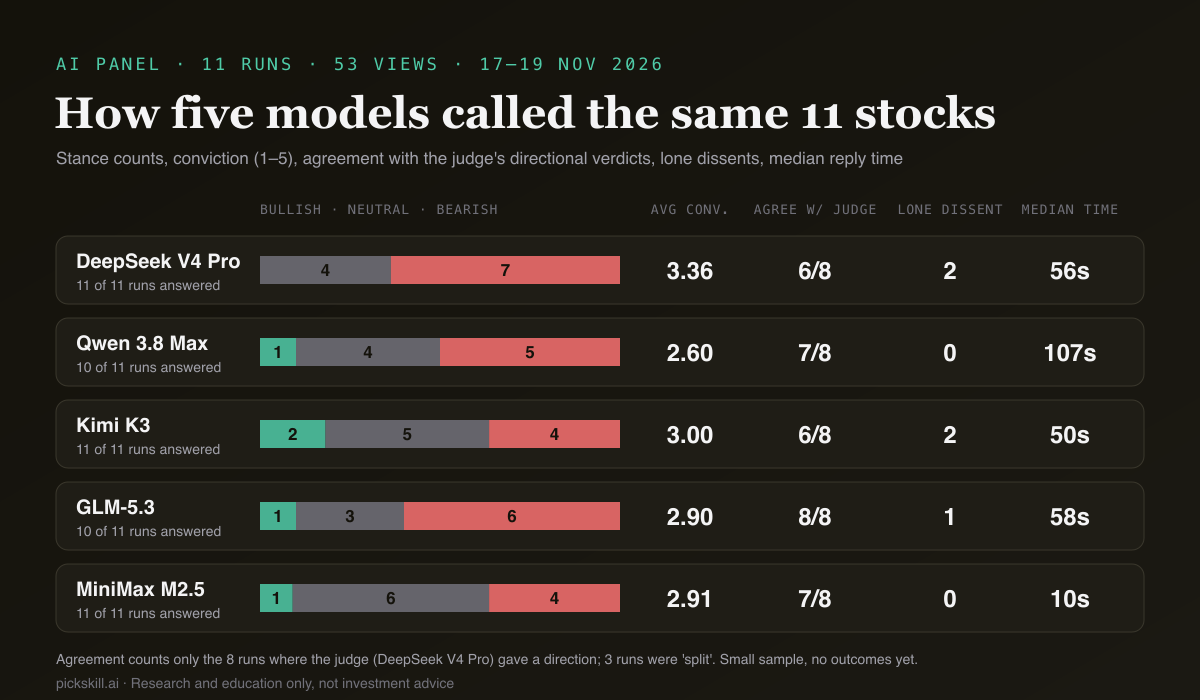
有两个现象值得注意。第一,五个模型整体偏空(26 条看空、22 条中性、5 条看多),这主要反映了输入本身:不少股票正在下跌,截至 11 月 17 日收盘,NVDA 五日下跌 7.95%,收于 155.46。第二,持有周期这一项没有区分度:53 条观点全部选了“数周”,因为提示词要求给出一到四周的观点。想看一次完整运行的拆解,请读五个 AI 模型分析 NVDA。
哪个模型最常和其他模型意见不同?
Kimi K3 和 DeepSeek V4 Pro 各有两次在其他模型意见一致时独自唱反调,GLM-5.3 一次,Qwen 3.8 Max 和 MiniMax M2.5 一次都没有。我们只在“其余模型立场完全相同、只有这一个不同”时才计为一次唯一异见。DeepSeek 的两次异见方向相反:MSFT 上其余四个中性、它看空;AMZN 上其余四个看多、它中性。GLM 唯一的一次是在 TSLA 上看空,而其余四个都是中性。分歧最大的是 600674.SS(川投能源):Kimi 看多、DeepSeek 看空、GLM 和 MiniMax 中性,裁判判为“分歧”。11 次中只有 3 次全体一致:AAPL(全部中性)、GOOGL 和 META(全部看空)。
异见不等于错误,它往往点出了多数人忽略的风险。比如 Kimi 在 NVDA 上给中性,依据是超卖读数(RSI 约 22),而其他模型更看重下跌趋势和资金流向。
裁判会偏向 DeepSeek 吗?
有可能,看“与裁判一致”这一列时要记住这一点。裁判就是 DeepSeek V4 Pro,和其中一位分析师是同一个模型。关于“LLM 当裁判”的研究记录过一种“自我增强”偏差,即模型会偏爱和自己相似的答案(Zheng 等,2023)。但在这 11 次运行中看不出这种效应:DeepSeek 自己的立场与结论一致 6/8 次,并列最低;GLM-5.3 则是 8/8。MSFT 上,裁判站在四个中性观点一边,而不是 DeepSeek 的看空;AMZN 上,裁判站在四个看多观点一边,而不是 DeepSeek 的中性。裁判还能看到投票统计,所以“与裁判一致”在一定程度上衡量的是与多数一致。
同一个模型问两次,答案一样吗?
不一定。NVDA 在同一份数据(11 月 17 日收盘 155.46)上跑了两次,一次输出中文,一次输出英文。两次都作答的四个模型中,三个改变了立场:DeepSeek 从中性(3)变为看空(4),Kimi 从看空(3)变为中性(3),MiniMax 从中性(2)变为看空(3)。只有 Qwen 两次都是看空、信心分 3。裁判结论也从“分歧”变成“看空”。只有一对样本,无法判断是输出语言还是正常的采样随机性导致的。无论哪种,一个模型的一次回答只是一个样本,而不是一次测量。
怎样自己比较 AI 模型的股票分析能力?
只要输入完全相同,你可以用任何模型输出复现这套对比。我们的方法如下:
- 固定输入。 给所有模型同一份带日期的数据(每只股票一份数据表)、同样的指令和同样的输出格式。
- 收集结构化输出。 把立场、1–5 分信心分和持有周期设为字段,这样就能计数,而不必解读大段文字。
- 记录失败。 记下哪个模型没作答、为什么(本例中一次超时、一次缺失)。缺失本身也是一种行为。
- 只计数,不打分。 按模型统计立场、平均信心分、与最终结论的一致次数和唯一异见次数。
- 等结果出来再排名。 准确率需要持有周期结束后的价格,最好覆盖多次运行和不同的市场环境。
脚本的核心部分,在导出的运行记录上执行:
for run in runs:
    views, verdict = run["result"]["views"], run["result"]["summary"]["verdict"]
    for m in MODELS:
        if m not in views:
            missing[m].append(run["ticker"]); continue
        v = views[m]
        stance[m][v["stance"]] += 1; conviction[m].append(v["conviction"])
        if verdict != "split":
            judged[m] += 1; agree[m] += v["stance"] == verdict
        others = {views[o]["stance"] for o in views if o != m}
        if len(views) >= 3 and len(others) == 1 and v["stance"] not in others:
            lone[m] += 1
那么,哪个 AI 模型最适合分析股票?
基于 11 次运行,诚实的回答是:取决于你想从模型那里得到什么,而准确率目前还是未知数。想要果断、价位清晰的判断,DeepSeek V4 Pro 下注最坚决。想要谨慎的第二意见,Qwen 3.8 Max 信心分很少超过 3,不过它最慢,还超时过一次。Kimi K3 最可能挑战共识。GLM-5.3 最贴近最终结论,MiniMax M2.5 则快得多。模型之间的分歧本身才是有用的信号,这也是 PickSkill 多模型会诊把五个观点并排展示、并附上裁判总结的共识与分歧的原因。想了解这如何融入更完整的研究流程,请看2026 年用 AI 做股票研究。
等足够多的运行走完持有周期、可以用价格打分时,我们会再做一次对比。本文仅供研究与学习,不构成投资建议。
FAQ
DeepSeek 和通义千问,哪个分析股票更好? 在基于 2026 年 11 月 17–19 日数据的 11 次运行中,DeepSeek V4 Pro 比 Qwen 3.8 Max 更果断(平均信心分 3.36 对 2.60),也更偏空,但目前还没有结果能判断谁更准。“更好”取决于你想要坚定的观点还是谨慎的观点,以及需要数周才能积累的准确率数据。
哪个大模型最擅长分析股票? 就我们的数据而言,还没有哪个大模型被证明稳定最好。在输入相同的情况下,五个模型的差异主要在信心分、唱反调的频率、稳定性和速度上。用同一份数据比较多个模型、看它们在哪里达成一致,比只信一个模型的回答更有参考价值。
为什么同一个 AI 模型分析同一只股票会给出不同答案? 大语言模型的输出带有采样随机性,同样的输入再跑一次可能得出不同立场。在我们的数据里,NVDA 在相同数据上分析了两次,四个模型中有三个改变了立场。请把任何一次 AI 回答都当作一个样本,去看多个模型或多次运行之间是否一致。
PickSkill 多模型会诊的最终结论是怎么得出的? 由 DeepSeek V4 Pro 担任裁判。它阅读五位分析师的观点和按信心分加权的投票,然后给出结论(看多、看空、中性或分歧)、主要共识与分歧、只做多的策略以及接下来要关注的信号。免费账户每月可运行一次多模型会诊;当天已有人分析过的股票可以免费查看。
能看到这些统计背后的完整分析吗? 可以。NVDA 那次运行的完整解读见我们的文章《五个 AI 模型分析 NVDA》。登录后,你也可以在多模型会诊页面亲自分析美股、港股、A 股、日股和韩股,查看每个模型的理由、风险和价位。